Dit artikel helpt beheerders, IT-medewerkers of ander technisch personeel dat ondersteuning biedt bij de uitrol van utility networks om te begrijpen hoe loggegevens die specifiek zijn voor de workflows geïnterpreteerd moeten worden. Dit artikel is op sommige plaatsen zeer technisch en vereist een grondige kennis van de concepten en technologieën die worden gebruikt om het utility network te beschrijven.
Bewerken: Als je zelf logbestanden wilt analyseren en verwerken, kun je de voorbeeld Python-tools vinden die gebruikt zijn om de grafieken in dit artikel te genereren hier.
Dit artikel is geschreven om beheerders, IT-medewerkers of ander technisch personeel dat ondersteuning biedt bij de uitrol van utility networks te helpen begrijpen hoe loggegevens die specifiek zijn voor de workflows geïnterpreteerd moeten worden. Dit artikel is op sommige plaatsen zeer technisch en vereist een grondige kennis van de concepten en technologieën die worden gebruikt om het utility network te beschrijven.
Om dit artikel te begrijpen moet je eerst het Utility Network Diagnostics-artikel hebben gelezen en ermee vertrouwd zijn. Dat artikel beschrijft hoe loggegevens kunnen worden vastgelegd voor verschillende utility network-operaties. Dit artikel bouwt voort op die concepten door enkele tips te geven voor het interpreteren van deze logs en hoe prestatiegegevens kunnen worden geëxtraheerd om de prestaties van je systeem te beoordelen. Deze logs vervangen geen tools zoals ArcGIS Monitor, maar stellen je in staat om dieper te graven en mogelijke prestatieknelpunten te onderzoeken.
Waarom is dit belangrijk?
Weten hoe je prestaties nauwkeurig kunt meten en beoordelen is een belangrijke vaardigheid, omdat het je in staat stelt de impact van je datamodellering of architecturale beslissingen kwantitatief vast te leggen. Je vindt een verzameling bronnen die de impact van deze beslissingen bespreken in de conclusie van dit artikel.
Opmerking: Dit artikel toont schermafbeeldingen van verschillende grafieken en logs, maar bevat geen voorbeeldgegevens om mee te werken. De grafieken gebruiken verschillende datasets en schalen en mogen niet worden gebruikt om conclusies te trekken. Je moet testen uitvoeren met je eigen gegevens om conclusies te trekken met behulp van de technieken die in dit artikel worden beschreven. De logs in dit artikel zijn afkomstig van ArcGIS Enterprise 12.1, dus nieuwere en oudere versies kunnen andere berichten tonen. De specifieke formulering en structuur van de logbestanden veranderen per release, daarom is het belangrijk dat je begrijpt hoe je logs moet interpreteren in plaats van specifieke berichten uit je hoofd te leren.
Een andere belangrijke les uit dit artikel is om na te denken over hoe logs worden gebruikt. Ze zijn een belangrijk hulpmiddel bij probleemoplossing en kunnen ook aantonen welke impact datamodelleringsbeslissingen, configuratie of zelfs architectuur kunnen hebben op prestaties en de eindgebruikerservaring.
Serverlogs bieden gedetailleerde informatie waarmee je de prestaties van specifieke operaties kunt meten, en in veel gevallen ook kunt correleren welke prestatie-effecten er zijn op specifieke subnetwerken of hoeveel objecten door die operatie worden beïnvloed. Bijvoorbeeld als een gebruiker klaagt dat subnetwerken te langzaam worden bijgewerkt.
Een normale prestatiebeoordeling zou de update subnetwork-operatie uitvoeren op alle subnetwerken in het systeem met één proces, om een grafiek te maken die responstijden toont die door deze server zijn geretourneerd. Dit levert een grafiek op zoals hieronder:
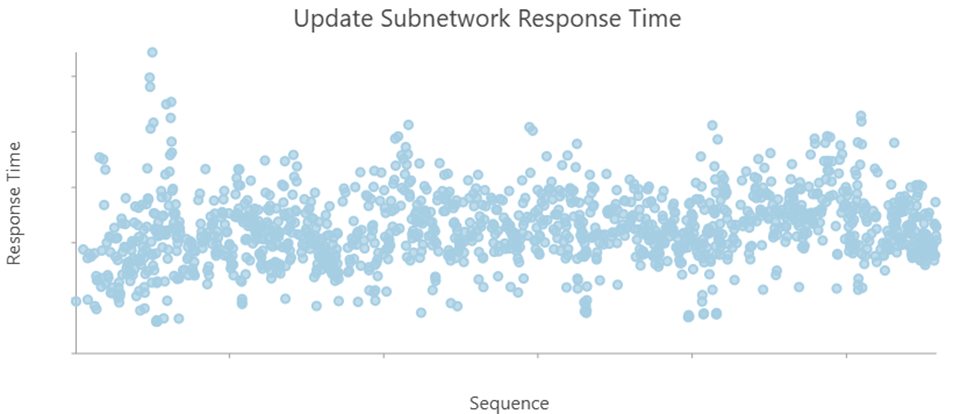
Hoewel het interessant is om de verdeling van responstijden te zien, geeft het geen inzicht waarom sommige reacties beter zijn dan andere of wat nader onderzoek vereist. Deze aanpak behandelt elke respons als gelijkwaardig, wat bij subnetwerken niet het geval is. Door de logbestanden te analyseren kun je grafieken maken die meer bruikbare inzichten bieden.
Een eenvoudige manier om problematische subnetwerken voor nader onderzoek te identificeren is door een grafiek te maken waarin de naam van het subnetwork uit de logs wordt weergegeven samen met de responstijd.
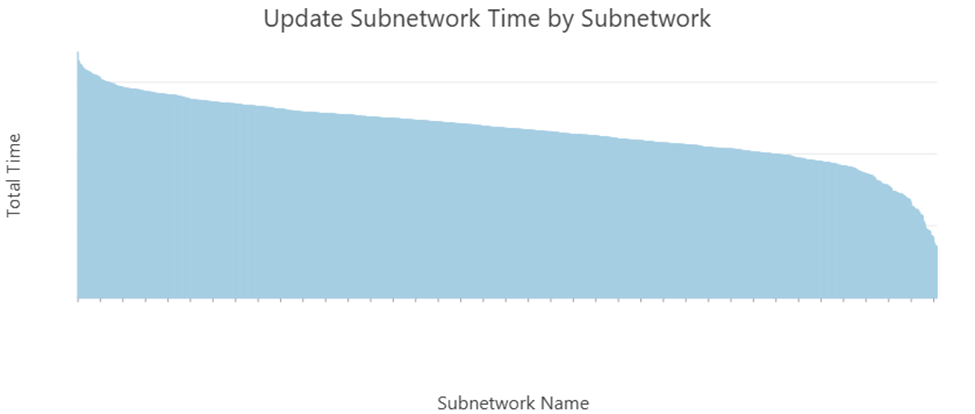
Dit stelt je in staat een specifiek subnetwork in de data te vinden voor onderzoek terwijl je ook een beeld krijgt van hoe het gehele systeem zich gedraagt. Dit maakt het makkelijker om je best en slechtst presterende subnetwerken te identificeren, evenals eventuele uitschieters.
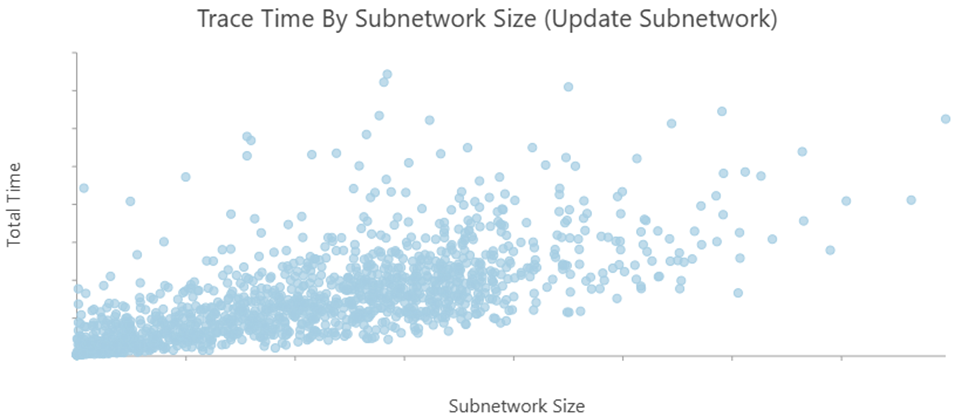
Met iets meer werk kun je ook het aantal objecten in elk subnetwork uit de logbestanden halen. Hiermee kun je een grafiek maken waarbij het aantal objecten per subnetwork op de X-as wordt weergegeven.
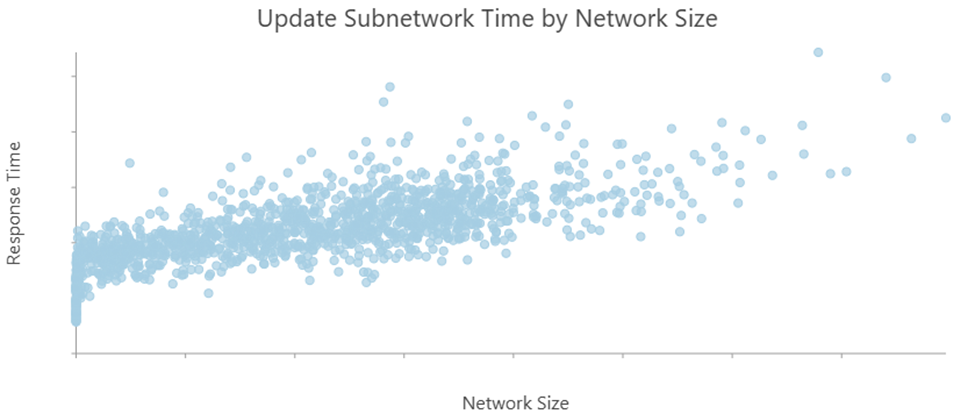
Deze grafiek maakt het eenvoudiger om de correlatie tussen netwerkgrootte en responstijd te zien. Dit laat zien dat meestal de subnetwerken die langer nodig hebben voor updates groter zijn. Ook zie je dat er enkele kleinere netwerken zijn die langer duren dan verwacht, zodat je daar extra aandacht aan kunt besteden.
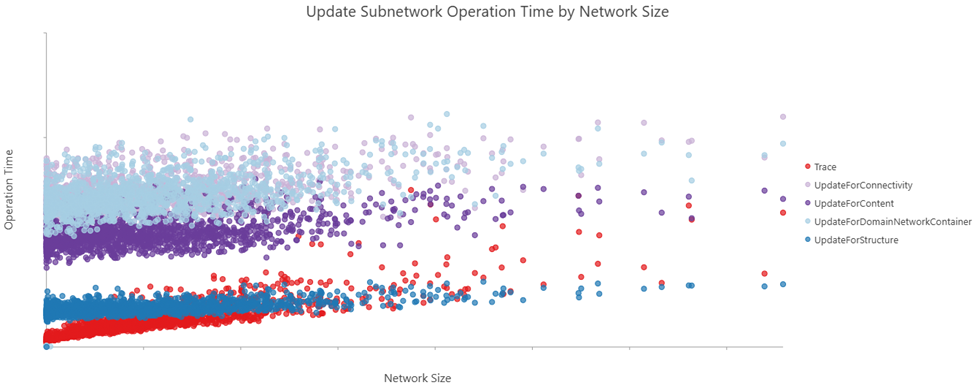
Je kunt deze aanpak nog verder uitbreiden door meer gedetailleerde informatie uit de logs te halen om zo de tijdsduur van specifieke operaties binnen elk subnetwork te bekijken.
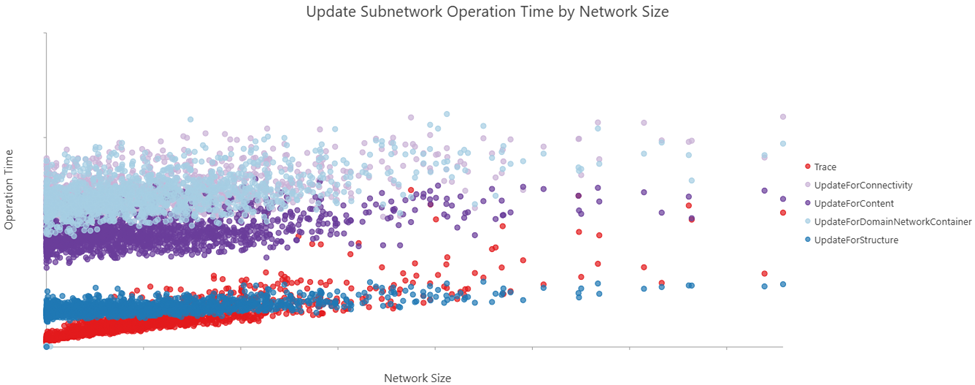
Deze grafiek laat zien welke operaties en subnetwerken het meeste tijd kosten. Deze gedetailleerde informatie stelt je in staat te onderzoeken welke stappen genomen kunnen worden om de timing van die specifieke operaties te verbeteren.
In dit artikel leer je enkele belangrijke overwegingen bij het interpreteren van tijden voor de volgende logs:
- Tracing gebruikt de TraceLog
- Update Subnetwork gebruikt de UpdateSubnetworkLog
- Export Subnetwork gebruikt de ExportSubnetworkLog
- Enable Network Topology en Validate Network Topology gebruiken de BuildLog
Voordat we ingaan op individuele logs, bespreken we eerst het belang van deze tools bij het isoleren en oplossen van prestatieproblemen.
Prestatie isoleren
Bij het oplossen van een prestatieprobleem in ArcGIS Enterprise kan het probleem veroorzaakt worden door allerlei architecturale, configuratie- of zelfs data-gerelateerde problemen. Als het probleem zich richt op één enkele operatie binnen het utility network zonder versiebeheer, is een goede manier om afhankelijkheden te verminderen en het probleem te isoleren door eerst het utility network naar een nieuwe mobiele geodatabase te kopiëren.
Door met een lokale mobiele geodatabase te werken kun je focussen op de prestaties van het utility network zelf zonder extra variabelen die samenhangen met de architectuur van ArcGIS Enterprise. Dit maakt dat je kunt focussen op een single-user workflow zonder versiebeheer.
De prestaties van het utility network in een lokale omgeving zijn niet gelijk aan die in een enterprise-omgeving. Toch kun je hiermee bepalen of een prestatieprobleem wordt veroorzaakt door data en configuratie binnen het utility network of door architectuur en configuratie van de omgeving.
Als het prestatieprobleem niet reproduceerbaar is in de lokale omgeving, kun je nog steeds informatie uit lokale tests gebruiken om je onderzoek binnen enterprise aan te vullen. Je kunt tijden en stappen uit gedetailleerde logs vergelijken tussen lokale geodatabase en enterprise geodatabase om na te gaan of bepaalde stappen langer duren. Dit kan wijzen op een databaseprobleem dat verder onderzocht kan worden via prestatieplannen met beschikbare tools voor jouw DBMS.
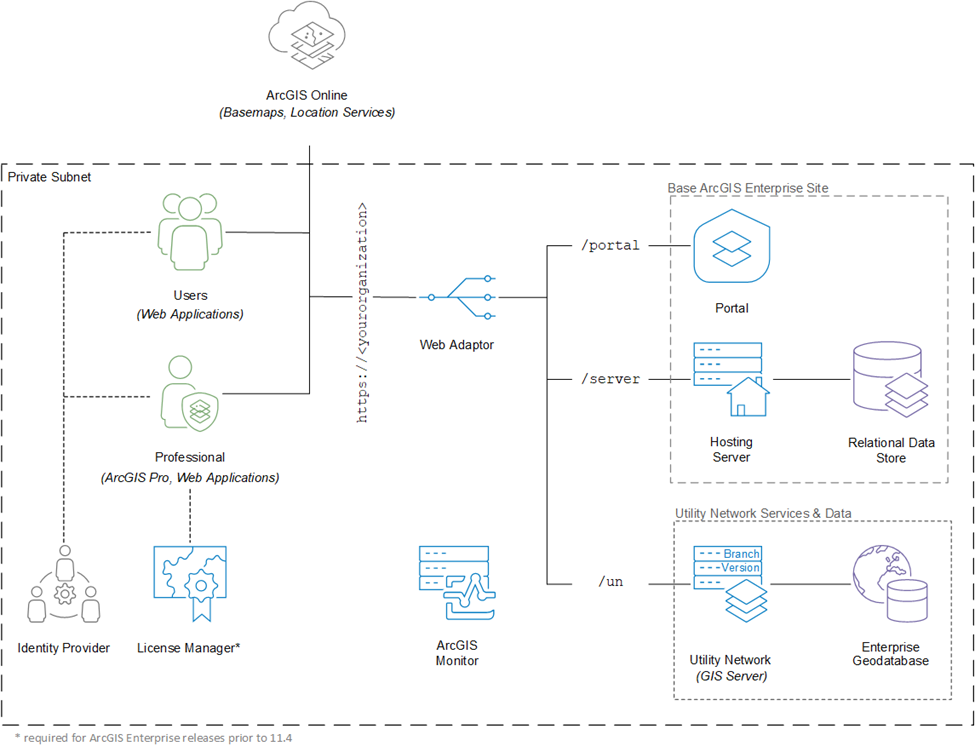
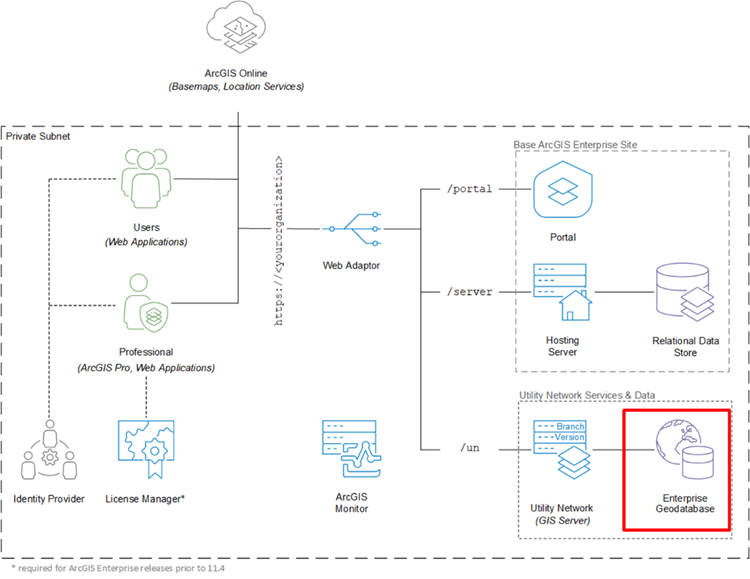
Je kunt ook tijden per operatie vergelijken zoals gerapporteerd door ArcGIS Server-logs met responstijden gemeld door de client. Grote verschillen of inconsistente responstijden kunnen duiden op communicatieproblemen tussen client en server. De onderstaande afbeeldingen tonen welke tijden door verschillende logs worden vastgelegd.
Het meten van client-responstijd omvat totale tijd besteed aan afhandeling van verzoeken op applicatie-, server- en datalaag binnen de architectuur. Dit is vaak niet nuttig voor het achterhalen van onderliggende oorzaken maar blijft belangrijk voor volledig begrip van context en workflow nodig om problemen na te bootsen.
De ArcGIS Server-logs richten zich op tijd besteed aan server- en datalaag, terwijl ze ook context bieden voor elk verzoek naast verstreken tijd.
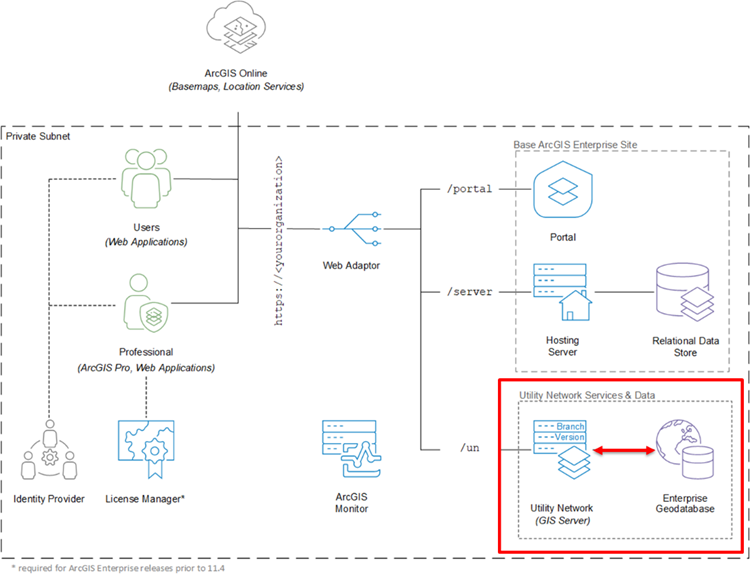
Het beoordelen van prestaties op database-niveau geeft ook nuttige inzichten bij database-gerelateerde problemen maar mist context vanuit client- of applicatielaag.
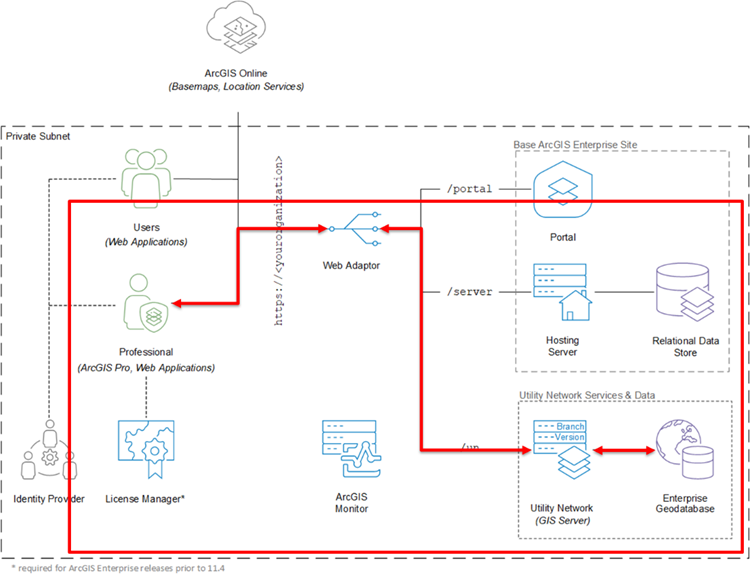
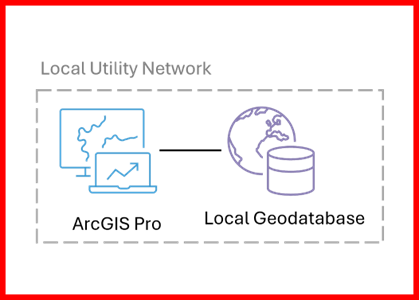
Data kopiëren naar een lokale mobiele geodatabase en logs vastleggen met Diagnostic Monitor in ArcGIS Pro is een krachtige methode om prestatieproblemen te isoleren. Dit komt doordat je zo controle hebt over workflow en context per operatie terwijl je prestaties meet met zo min mogelijk afhankelijkheden. Hieronder zie je een diagram van dit scenario.
Nu je begrijpt hoe en waarom prestatieproblemen geïsoleerd moeten worden tijdens testen, bekijken we hoe utility network-logs geanalyseerd kunnen worden voor prestatie-informatie.
Trace Log
De Trace Log heeft vier belangrijke secties:
- Omgeving
- Trace Parameters
- Stappen en tijden
- Netwerkindexstatistieken
Bij beoordeling van systeemprestaties wordt vaak gekeken naar totale tijd per trace vergeleken met aantal teruggegeven elementen. Het meest gebruikte testschema hiervoor is een subnetwork trace uitvoeren voor elk subnetwork binnen utility network gevolgd door meten hoelang deze trace duurde versus aantal elementen per subnetwork.
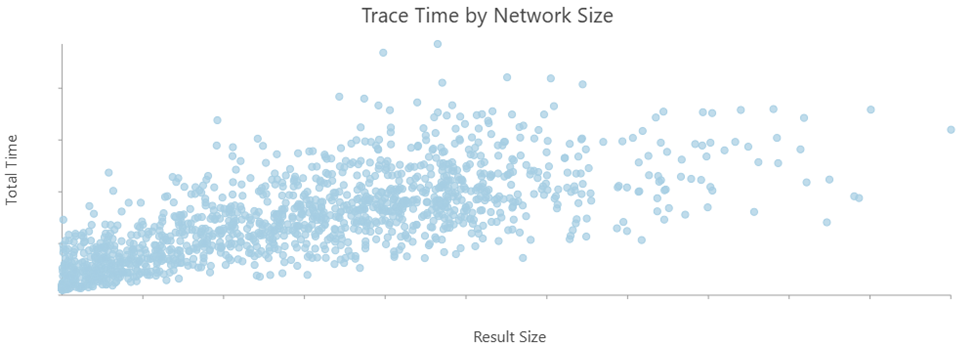
De trace op hetzelfde subnetwork geeft verschillende prestatiewaarden afhankelijk of het gaat om een gebruikersconfiguratie trace of trace gebruikt bij export subnetwork of update subnetwork operaties. Bij meten prestaties traces moet gekeken worden naar prestaties subnetwork traces volgens standaardconfiguratie tijdens update subnetwork. Als export subnetwork gepland is moet ook trace-prestaties tijdens export gemeten worden volgens verwachte configuratie.
Als een bepaald subnetwork ondermaats presteert kun je vervolgens kijken naar tijd per individuele stap per subnetwork versus aantal elementen per subnetwork.
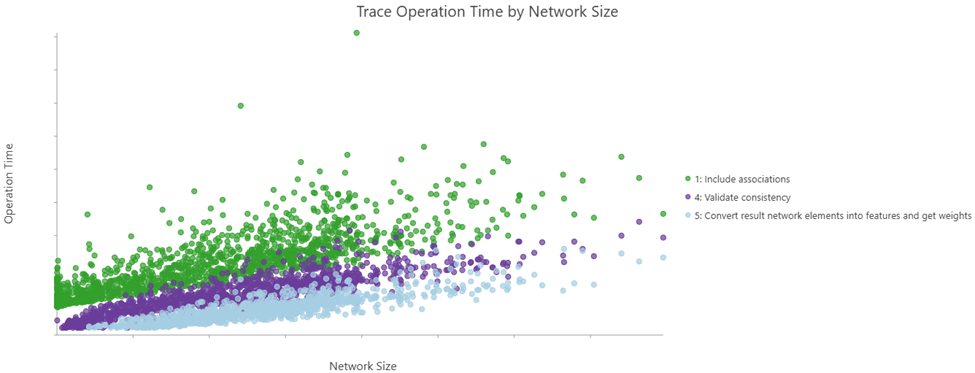
Wanneer je naar de verschillende stappen van een trace-operatie kijkt, begin je te begrijpen waarom bepaalde traces langer duren en welke grote invloed de configuratie van een trace heeft op de algehele prestaties.
Als voorbeeld, als je een grafiek zoals deze gebruikt om de prestaties van een trace te analyseren na het toevoegen van functies of specifieke resultaattypen, kun je de prestatiekosten van die specifieke wijzigingen meten, waarbij elke wijziging wordt weergegeven als een eigen operatie met een bijbehorende kost.
Omgeving en Trace Parameters
De configuratiesectie helpt je de context van de trace te begrijpen. Het geeft het type trace, versie, startpunten en traceconfiguratie weer, samen met de voor de trace opgegeven resultaattypen. Al deze parameters beïnvloeden het gedrag van de trace. Een wijziging in één ervan zou een ander resultaat opleveren en kan de prestaties beïnvloeden.
Stappen en tijden
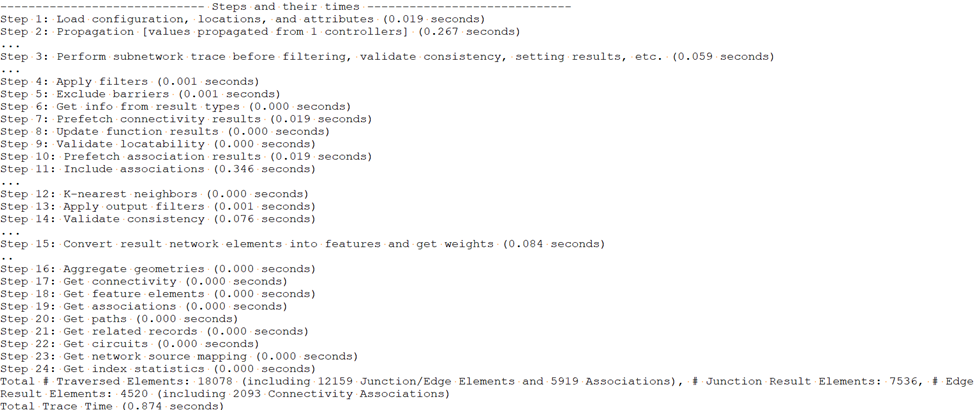
Dit gedeelte van het logboek bevat gedetailleerde informatie over alle uitgevoerde operaties tijdens de trace en hoe lang elke stap duurde. Sommige stappen bevatten ook informatie over hoeveel features betrokken waren bij die stap van de trace.
Bij het analyseren van de tijd wil je eerst kijken naar hoe lang de totale trace duurde, daarna naar de grootte van de resultaten. Het aantal doorlopen en geretourneerde elementen staat aan het einde van 'stappen en tijden' met de volgende regels:

De Totale Trace Tijd is gemakkelijk te begrijpen; dit is de totale tijd die nodig was om de trace uit te voeren. Het aantal ontdekte elementen vereist wat meer overweging omdat het zowel het aantal doorlopen elementen als het aantal elementen in het resultaat omvat.

Dit is belangrijk omdat veel traces veel elementen doorlopen maar slechts een deel van de resultaten teruggeven. Ook al wordt een klein aantal features geretourneerd, kan de trace veel features moeten analyseren. Voorbeelden hiervan zijn upstream- of downstream-traces, traces met een filterbarrière geconfigureerd, of traces uitgevoerd tijdens update subnetwork om features in meerdere subnetwerken te ontdekken. Daarom zijn doorlopen elementen vaak een betere voorspeller van prestaties dan de grootte van het resultaat.
Je wilt ook de individuele stappen en hun tijden tijdens de trace bekijken. Deze details laten zien waar tijdens de trace tijd wordt besteed.
Netwerkindexstatistieken
De netwerkindexstatistieken laten zien hoeveel netwerkinformatie uit de database werd geladen tijdens de analyse. Deze logs worden meestal alleen door support en ontwikkeling gebruikt om specifieke problemen te diagnosticeren.
Deze sectie bevat de volgende statistieken:
- Topologietabelstatistieken – Een samenvatting van hoeveel rijen werden gelezen uit de netwerktopologie.
- Associatietabelstatistieken – Een samenvatting van hoeveel associaties werden gelezen.
- Weight engine-statistieken – Een samenvatting van hoeveel netwerkattributen werden gelezen.
- Geheugenbeheerstatistieken – Een samenvatting van het gebruikte geheugen.
Als je besluit om in deze statistieken te duiken, merk je misschien dat niet alle netwerkattributen worden gerapporteerd in het Weight engine-statistiekengedeelte. Dit komt omdat network attributes stored in-line worden opgeslagen binnenin de topologietabellen en worden meegenomen wanneer toegang wordt verkregen tot connectiviteit voor een feature vanuit de database. Elk out-of-line netwerkattribuut dat uit de netwerkindex wordt gelezen heeft een kleine kost eraan verbonden, meestal niet meer dan enkele milliseconden voor een klein netwerk. Maar wanneer veel out-of-line netwerkattributen worden gelezen of wanneer het netwerk veel groter is, kan deze kost merkbaar worden.
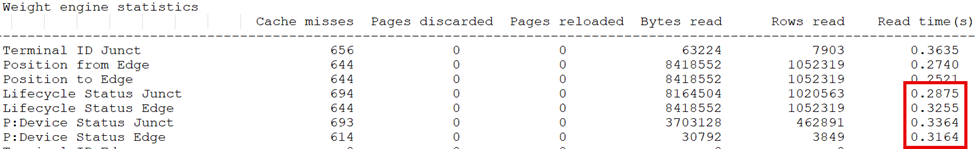
Dit is waarom je zou moeten overwegen om netwerkattributen die nodig zijn voor het merendeel van je traces in-line op te slaan, vooral die welke worden verwezen door je subnetworkdefinitie. Waarom worden niet alle netwerkattributen in-line opgeslagen? Omdat er beperkte opslagruimte beschikbaar is voor in-line netwerkattributen, moet je beslissen welke attributen het belangrijkst zijn en ervoor zorgen dat deze in-line worden opgeslagen. Je zult ook merken dat network attributes stored in-line niet verschijnen in de netwerkindexstatistieken.
Bij het vergelijken van resultaten tussen twee tests kun je ook kijken naar cache misses om te bepalen hoeveel er beschikbaar was in het geheugen (gecached) versus rijen gelezen uit de database.
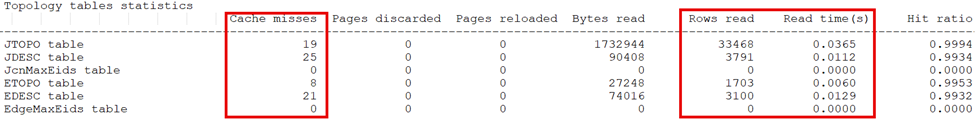
Bij het vergelijken van prestaties tussen verschillende traces of operaties is het belangrijk om op het aantal cache misses te letten. Een trace die volledig vanuit geheugen (hot cache) wordt uitgevoerd presteert beter dan dezelfde trace die connectiviteitsinformatie uit de database moet laden (cold cache).
Er is niet veel wat je kunt doen om dit te beheersen in gebruikersworkflows, maar het is belangrijk om hier rekening mee te houden bij het opzetten van een consistente testmethodologie zodat je resultaten van verschillende tests nauwkeurig kunt vergelijken. De meest conservatieve en consistente manier om resultaten te meten is ervoor te zorgen dat alle tests worden uitgevoerd tegen een cold cache.
Update Subnetwork Logboek
Bij het beoordelen van de prestaties van update subnetwork wil je beginnen met het bekijken van het Update Subnetwork Logboek dat tijdens de update subnetwork-operatie is gemaakt. Daarnaast wil je vaak ook het Trace Log bekijken dat bij elk subnetwork hoort, aangezien dit vaak verantwoordelijk is voor het grootste deel van de tijd besteed aan het updaten van een subnetwork.
Opmerking: Bij het bekijken van het Trace Log voor update subnetwork merk je misschien dat stappen en tijden anders zijn dan wanneer je gewoon een trace uitvoert. Dit hangt af van je netwerkconfiguratie, maar je zult meer tijd zien besteed aan het vinden van elementen in meerdere subnetwerken (voor netwerken met propagatie), tijd besteed aan het ophalen van geometrie om de subnetworklijn te berekenen, evenals tijd besteed aan het berekenen van functies voor de geaggregeerde lijn.
Net als bij het Trace Log zijn er drie secties in het update subnetwork logboek.
- Omgeving
- Subnetwork Parameters
- Stappen en tijden
- Netwerkindexstatistieken
Bij het beoordelen van de prestaties van update subnetwork neem je de volgende informatie mee:
- Hoe lang duurde het om het subnetwork bij te werken?
- Hoe groot was het bijgewerkte subnetwork?
- Hoeveel features zijn bijgewerkt?
De eerste twee zijn gemakkelijk terug te vinden in het logboek; voor de laatste moet je lezen hoeveel features veranderd zijn.
Bij beoordeling van algemene systeemprestaties kijk je meestal naar hoeveel tijd nodig is om elk subnetwork in het systeem bij te werken versus het aantal features in dat subnetwork.
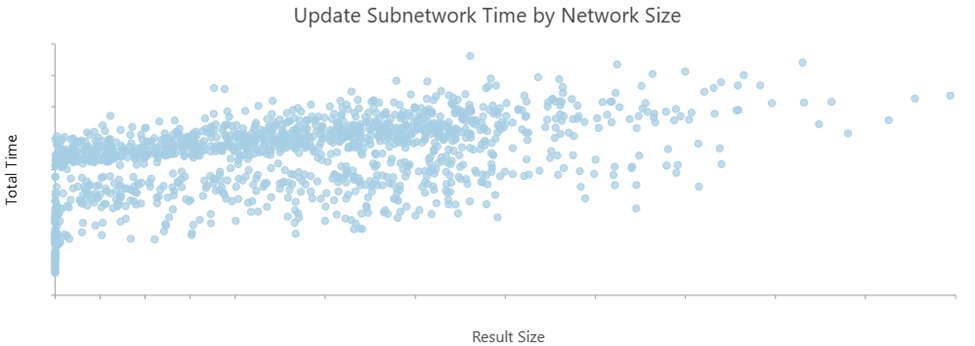
Bij deze analyse kun je drie verschillende scenario's overwegen:
- Hoe lang duurt de eerste update subnetwork-operatie?
- Hoe lang duurt het om een subnetwork bij te werken als er niets veranderd is?
- Hoe lang duurt het om een subnetwork bij te werken als er een redelijk aantal features veranderd zijn?
Je wilt meestal focussen op hoe lang update subnetwork duurt bij een redelijk aantal bewerkingen, omdat dit is wat gebruikers dagelijks ervaren. De eerste update subnetwork is belangrijk omdat deze meestal het meest tijdrovend is en moet worden uitgevoerd wanneer het systeem wordt uitgerold. Het scenario zonder wijzigingen is interessant omdat dit het best mogelijke prestatieresultaat is.
Als je een onderpresterend subnetwork vindt, kun je naar individuele stap-tijden kijken om te bepalen of er één stap is die veruit de meeste tijd inneemt.
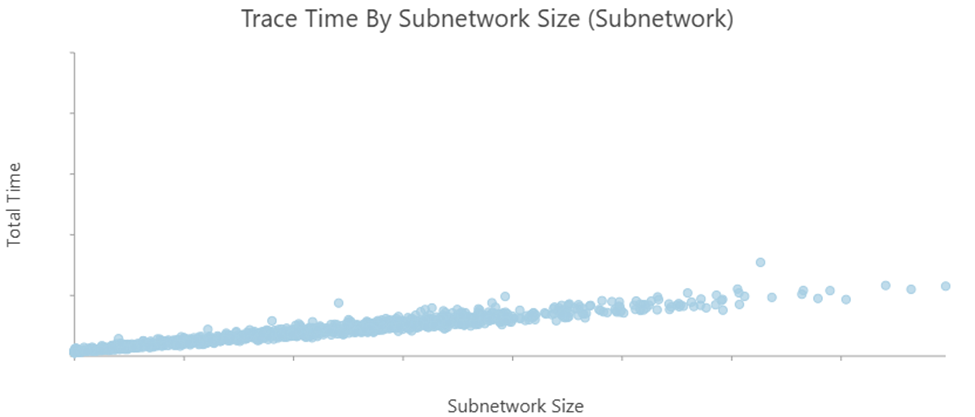
Als je vergelijkt hoeveel tijd een trace kost tijdens update subnetwork met een normale subnetworktrace, zul je meestal zien dat die tijdens update subnetwork langer duurt. Dit komt doordat update subnetwork extra werk doet zoals geometrieën laden voor aggregatie, samenvattingsfuncties berekenen en soms elementen zoeken in meerdere subnetwerken.
Omgeving en Subnetwork Parameters
Bij het bekijken van de configuratiesectie in het logboek moet je goed letten op deze configuraties:
- Versienaam
- Bewerkingsmodus
- Tiernaam
De versienaam en bewerkingsmodus zijn belangrijk omdat gedrag en tijdsduur voor update subnetwork kunnen verschillen afhankelijk van gebruikte bewerkingsmodus en of dit gebeurde in standaard- of benoemde versie. Meer hierover lees je in Understanding Subnetworks: Edit mode artikel. Kort gezegd brengt bewerkingsmodus ‘with events’ extra prestatiekosten mee door attribuutregels, terwijl ‘without events’ uitgeschakeld in een benoemde versie mogelijk niet alle features in het subnetwork bijwerkt.
Het is ook belangrijk om naar tiernaam te kijken bij prestatiebeoordeling omdat traceconfiguratie per tier bepaalt hoe update subnetwork zich gedraagt met betrekking tot creëren of bijwerken van een subnetwerklijn, netwerkschema’s enzovoort.
Stappen en tijden
Bij stappen en tijden richt je je vooral op deze secties:
- Trace
- De verschillende update-stappen (Connectiviteit, Inhoud enz.)
- Beheer van subnetwerklijn
- Beheer van netwerkschema’s
- Totaal
Je kijkt naar Trace om te zien hoe lang deze duurde en vooral hoeveel features onderdeel bleken te zijn van het subnetwork.
Vervolgens kijk je hoeveel tijd werd besteed aan updaten van diverse attributen in database die persistente subnetwerkinformatie bijhouden (subnetwerknaam, is verbonden enz.).
De tijd besteed aan beheer van subnetwerklijn en netwerkschema’s is meestal relatief klein. Maar als ze significant veel tijd kosten moet je mogelijk configuraties hiervan herzien.
De Totaal-regel geeft aan hoeveel totale tijd nodig was om subnetwork bij te werken.
Netwerkindexstatistieken
's Overwegingen voor reviewen netwerkindexstatistieken voor update subnetwork zijn hetzelfde als voor Trace Log.
Exportlogboek
Bij beoordeling prestaties export subnetwork neem je drie zaken mee:
- Welke resultaattypen, attributen enzovoort werden geëxporteerd?
- 's Hoe lang duurde het om alle informatie die door trace werd gevraagd te exporteren?
- 's Hoe lang duurde bestandsgeneratie?
Om deze vragen te beantwoorden, kijkt u voornamelijk naar het Exportlogboek. Er wordt een TraceLog gegenereerd voor de trace die wordt uitgevoerd als onderdeel van de export subnetwork-operatie als u een meer gedetailleerde uitsplitsing van de bestede tijd tijdens die operatie nodig heeft.
Binnen het Exportlogboek zijn er vijf verschillende secties:
- Omgeving
- Subnetwerkparameters
- Exportparameters
- Stappen en hun tijden
- Statistieken netwerkindex
Bij het beoordelen van de algehele prestaties van export subnetwork wilt u de tijd vergelijken die nodig was om export subnetwork uit te voeren met het aantal geëxporteerde features. In tegenstelling tot TraceLog en UpdateSubnetworkLog bevat het echter geen telling van hoeveel features door de trace zijn geretourneerd.
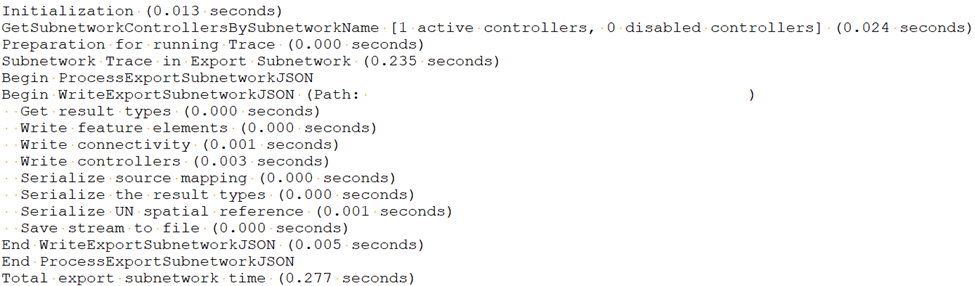
Het aantal features kan echter worden gehaald uit de TraceLog.

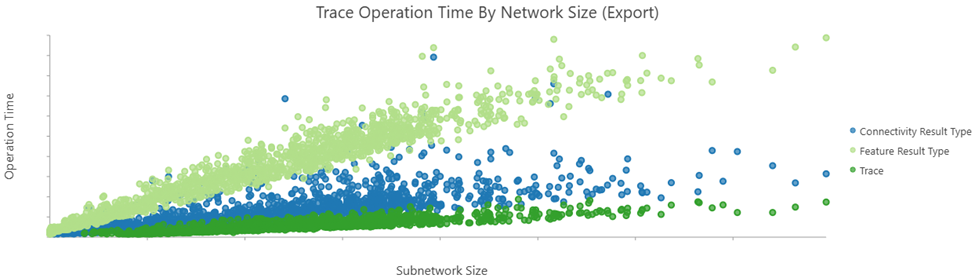
Wanneer u een subnetwerk ziet dat ondermaats presteert tijdens de exportoperatie, wilt u kijken waar de tijd in het exportlogboek wordt besteed. Als het merendeel van de tijd aan de trace wordt besteed, wilt u het tracelogboek bekijken. Het is vaak nuttig om dit te vergelijken met de tijd die tijdens een trace in export wordt besteed met de tijd die tijdens een normale subnetwerktrace wordt besteed (zonder resultaattypes of functies).
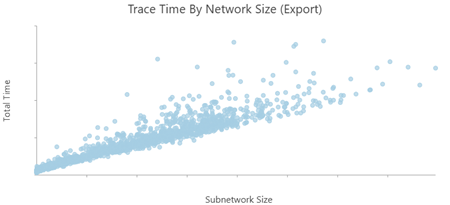
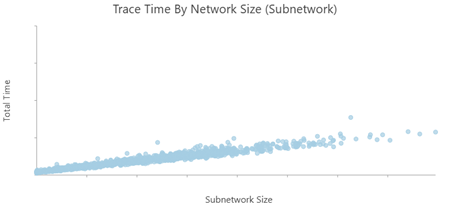
Deze aanpak stelt u in staat te identificeren hoeveel tijd wordt besteed aan elke resultaattype (connectiviteit, feature-elementen, enz.) tijdens de trace in export subnetwork, samen met hoeveel tijd aan het uitvoeren van de trace werd besteed. De trace tijdens export duurt altijd langer dan een gewone trace omdat er extra informatie uit de database moet worden gelezen. Door naar de details van het tracelogboek tijdens export te kijken, ziet u hoeveel tijd wordt besteed aan het ophalen van elk resultaattype.
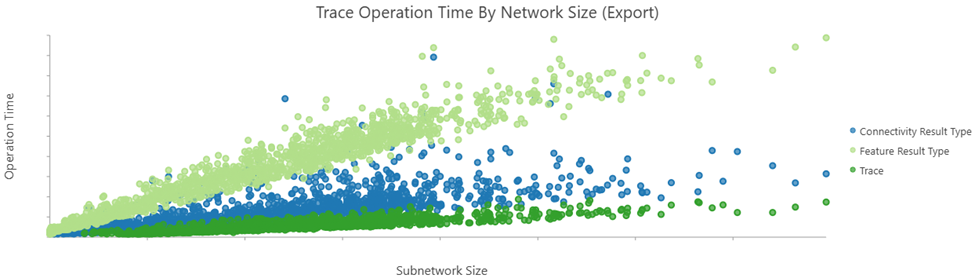
Daarom is het belangrijk dat u alleen de attributen en andere informatie exporteert die noodzakelijk zijn, omdat het exporteren van onnodige informatie hoge kosten met zich mee kan brengen.
Omgeving en parameters
Export subnetwork heeft veel opties die bepalen wat u kunt exporteren. Hoe meer informatie u echter opneemt in de export, hoe langer de trace duurt die wordt gebruikt om alle informatie te verzamelen. Hoe meer informatie u opneemt in de export, hoe groter de bestanden worden en hoe langer het duurt om ze te genereren en te downloaden.
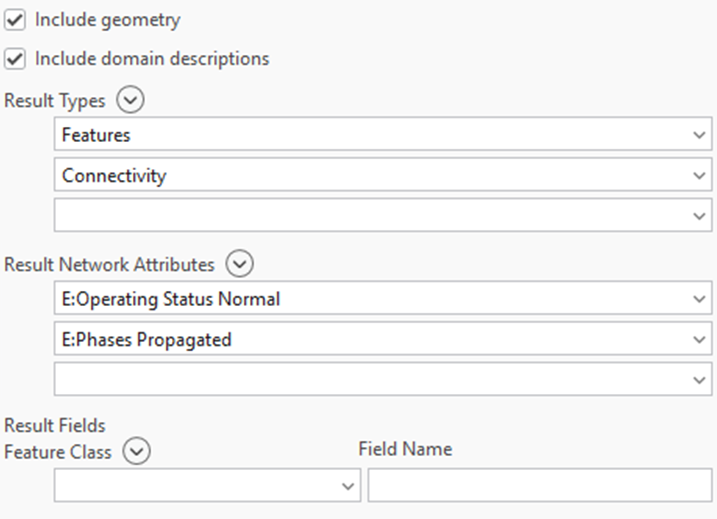
U kunt zien welke informatie een gebruiker heeft opgegeven om op te nemen in hun export door naar het gedeelte exportparameters van het rapport te kijken. Dit laat zien welke resultaattypes zijn opgenomen, evenals hoeveel netwerkattributen, resultaatsvelden (voor features) en gerelateerde recordvelden (voor gerelateerde records) zijn geselecteerd.
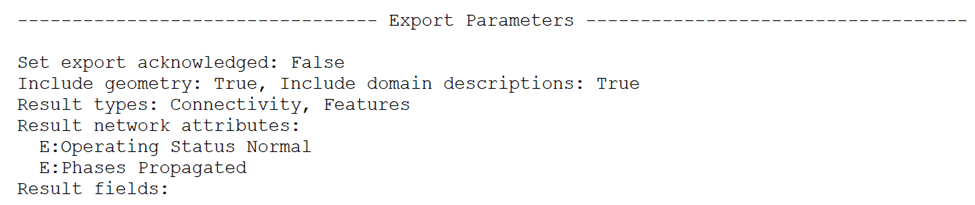
Het opnemen van veel attributen van features en gerelateerde records vereist extra queries naar de database, wat meer tijd kan toevoegen aan de trace om deze informatie te verkrijgen. Bovendien kan het selecteren van veel attributen de bestandsgrootte drastisch vergroten. Het opnemen van alle netwerkattributen voor een subnetwerk kan de bestandsgrootte en de tijd die nodig is om het subnetwerk te exporteren verdubbelen. Het opnemen van attributen uit veel verschillende tabellen zal een nog grotere negatieve invloed op de prestaties hebben.
Stappen en tijden
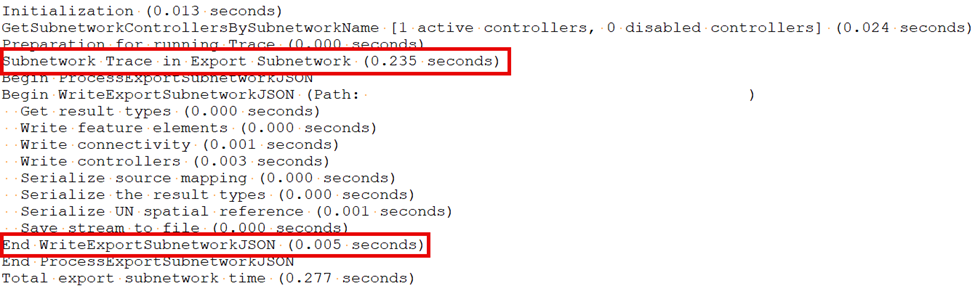
Er zijn minder stappen om te analyseren in het export subnetwork logboek. In de meeste gevallen zal de trace tijdens export subnetwork het grootste deel van de kosten veroorzaken. Als u echter ziet dat er veel tijd wordt besteed aan de Process/Write JSON-stappen, duidt dit erop dat het bestand groot is en lang duurt om te serialiseren, downloaden en opslaan.
Statistieken netwerkindex
De overwegingen voor het beoordelen van netwerkindexstatistieken voor export subnetwork zijn hetzelfde als voor het TraceLog.
Buildlogboek
Het formaat van het buildlogboek verschilt van de andere utility network diagnostische logboeken omdat het is ontworpen als een incrementeel logboek dat wordt gegenereerd tijdens mogelijk langdurige sessies. Daarom rapporteert elke regel in het buildlogboek hoeveel tijd nodig was om die stap te voltooien, hoeveel totale tijd tot dat punt is verstreken en hoeveel geheugen op dat moment werd gebruikt.
Voor alle drie build-operaties wordt hetzelfde logbestandsformaat gebruikt:
- Netwerktopologie inschakelen
- Netwerktopologie uitschakelen
- Netwerktopologie valideren
Hierdoor kan het voorkomen dat sommige stappen in bepaalde logboeken lijken overgeslagen te zijn. Dit komt omdat niet alle stappen op alle operaties van toepassing zijn.
Bij het beoordelen van de logboeken wilt u zich richten op de volgende secties
- Omgeving
Stappen en hun tijden
- Netwerk build setup
- Post-build verwerking
- Statistieken netwerkindex
Bij het evalueren van prestaties wilt u rekening houden met welk type build plaatsvindt, hoeveel netwerkattributen worden verwerkt, hoeveel beschikbaar geheugen/schijfruimte er is, of er analyses zijn uitgevoerd om subnetwerken te identificeren die door de validatie worden beïnvloed (post-build verwerking), en hoeveel features worden verwerkt. Het merendeel van deze informatie is beschikbaar in de omgeving- en netwerk build setup-secties van het logboek.
Voor Netwerktopologie inschakelen en Netwerktopologie uitschakelen bent u vooral geïnteresseerd in doorvoersnelheid, geheugengebruik en schijfgebruik. Hoe meer u kunt vertrouwen op geheugen om de netwerktopologie op te bouwen, hoe sneller dit zal gaan, maar voor grote datasets is dit niet realistisch. In die gevallen begint het buildproces gegevens naar schijf te schrijven; dan moet u ervoor zorgen dat de geconfigureerde schijf snel is (bij voorkeur een SSD) en dat er voldoende schijfruimte is voor tijdelijke bestanden.
Voor Netwerktopologie valideren bent u vooral geïnteresseerd in de totale tijd die nodig was om het netwerk op te bouwen, aangezien een gebruiker meestal Netwerktopologie valideren aanroept en u wilt minimaliseren hoe lang zij moeten wachten. Als u merkt dat er veel tijd wordt besteed aan post-build verwerking, dan wilt u vertrouwd raken met het Artikel Over Subnetwerken Status begrijpen. Dit gedrag wordt geregeld door de subnetwerkdefinitie voor elke laag in het netwerk en kan zelfs na implementatie van uw utility network worden aangepast. Utility networks die zijn geconfigureerd om een statusveld bij te houden voor hun subnetwerken moeten post-build verwerking uitvoeren tijdens Netwerktopologie valideren om zo subnetwerken te vinden die door deze validatie worden beïnvloed zodat ze als 'dirty' kunnen worden gemarkeerd.
Omgeving en netwerk build setup
De gevalideerde omvang wordt weergegeven in het omgeving-gedeelte van het buildlogboek; deze omvang is alleen relevant bij evaluatie van Netwerktopologie valideren. Dit komt omdat Netwerktopologie inschakelen en Netwerktopologie uitschakelen altijd over de volledige omvang van het netwerk lopen.
De stappen voor netwerk build samen met de naam van het logbestand tonen welk type build werd uitgevoerd. U kunt ook zien hoeveel netwerkattributen, geheugen en schijfruimte beschikbaar waren toen het proces begon. Als het gebruikte geheugen tijdens build groter is dan beschikbaar geheugen, begint het proces naar schijf te schrijven en vertraagt dit.
Stappen en hun tijden
Er zijn veel stappen tijdens het netwerkbuildproces; hoewel ze hier niet allemaal beschreven worden, moet u bij het beoordelen van logboeken rekening houden met:
- Hoeveel informatie werd tijdens deze stap verwerkt?
- Hoeveel informatie werd tijdens deze stap aangemaakt?
- Hoeveel tijd/geheugen gebruikte deze stap?
Elke stap rapporteert doorgaans in zijn laatste bericht hoeveel totale tijd nodig was om die stap af te ronden.
U kunt zien hoeveel tijd de hele operatie kostte door naar de laatste regel van het logbestand te kijken.
Om vast te stellen hoeveel geheugen werd gebruikt vergelijkt u het totaal gerapporteerde geheugen bij het eerste logbericht voor die stap met dat bij het laatste logbericht voor dezelfde stap.
Statistieken netwerkindex
Omdat het netwerkbuildproces de netwerkindex vult, kan deze sectie interessant zijn om te begrijpen hoeveel informatie systeemtabellen hebben gelezen, geschreven of aangemaakt tijdens dit proces. Er valt echter weinig aan deze cijfers te veranderen zodra een utility network is geïmplementeerd.
Als u zich nog vroeg in een project bevindt, kunt u zien wat voor impact uw aantal netwerkattributen heeft en kunt u ervoor zorgen dat u alleen die netwerkattributen gebruikt die echt nodig zijn in uw model. Als u geen netwerkattributen nodig hebt voor workflows en nog vroeg bent in uw project zodat u ze uit uw model kunt verwijderen, overweeg dit dan zeker. U kunt altijd later een netwerkattribuut toevoegen aan een netwerk; eenmaal geïmplementeerd kan dit echter niet meer verwijderd worden.
Als u overweegt of gerelateerde records als zodanig gemodelleerd moeten blijven of als niet-ruimtelijke objecten met connectiviteit en/of containment gemodelleerd moeten worden, kunt u zien hoe lang het duurt om een netwerk op te bouwen waarin deze extra niet-ruimtelijke objecten zijn opgenomen.
Conclusie
Nu u dit artikel hebt gelezen, zou u bekend moeten zijn met hoe logs geïnterpreteerd kunnen worden voor vier belangrijke operaties binnen utility network. U kunt prestatie-tests uitvoeren en resultaten tot in detail interpreteren. Bij ontwerpbeslissingen omtrent architectuur en data-modellering kunt u zo ook meten wat deze beslissingen betekenen voor uw prestaties.
Voor een systematischere aanpak bij vastleggen en meten van prestatiecijfers kunt u wellicht gebruikmaken van een tool zoals Extract Log Files, waarmee logs gecombineerd kunnen worden in een database. De grafieken in dit artikel werden gemaakt via een methode waarbij prestatiecijfers uit elk logbestand werden gehaald met reguliere expressies en gebruikt werden voor visualisaties.
Deze logbestanden zijn belangrijk omdat ze nauwkeurig meten hoeveel tijd een server besteedt aan specifieke operaties. Ze zijn zeer waardevol voor beoordeling van één enkele operatie; ze geven echter geen volledig beeld. Prestatieanalyse moet holistisch gebeuren zodat niet alleen prestaties binnen utility network beoordeeld worden maar ook hoe architectuur prestaties beïnvloedt én hoe systeem presteert onder belasting.
Voor voorbeelden van een meer holistische benadering bij testen en ontwerp bezoekt u ArcGIS Architecture Center.
Voor voorbeelden hoe modelleren van gerelateerde records prestaties kan beïnvloeden verwijzen we naar Modeling related data in a utility network.artikel
Voor voorbeelden van hoe de configuratie van je bewerkingsmodus van je subnetwerk de prestaties van het bijwerken van het subnetwerk kan beïnvloeden, lees de Understanding Subnetwork Edit Mode artikel.
Voor voorbeelden van hoe de statusbeheerconfiguratie van je subnetwerk de prestaties van het valideren van de netwerktopologie kan beïnvloeden, lees de Understanding Subnetwork Status artikel.