Cet article aide les administrateurs, le personnel informatique ou autre personnel technique supportant le déploiement du utility network à comprendre comment interpréter les informations des journaux spécifiques à ses flux de travail. Cet article est très technique à certains endroits et nécessite une bonne compréhension des concepts et technologies utilisés pour décrire le utility network.
Modification : Si vous souhaitez effectuer votre propre analyse et parsing des journaux, vous pouvez trouver les outils Python exemples utilisés pour générer les graphiques dans cet article ici.
Cet article a été rédigé pour aider les administrateurs, le personnel informatique ou autre personnel technique supportant le déploiement du utility network à comprendre comment interpréter les informations des journaux spécifiques à ses flux de travail. Cet article est très technique à certains endroits et nécessite une bonne compréhension des concepts et technologies utilisés pour décrire le utility network.
Pour comprendre cet article, vous devez d'abord avoir lu et être familier avec l'article Utility Network Diagnostics. Cet article décrit comment capturer les informations des journaux pour différentes opérations du utility network. Cet article s'appuie sur ces concepts en fournissant quelques conseils pour interpréter ces journaux et comment extraire des métriques de performance afin d'évaluer la performance de votre système. Ces journaux ne remplacent pas des outils comme ArcGIS Monitor mais vous permettent d'examiner en profondeur et d'enquêter sur d'éventuels goulets d'étranglement de performance.
Pourquoi est-ce important ?
Savoir mesurer et évaluer précisément la performance est une compétence importante, car elle vous permet de quantifier l'impact de vos décisions en modélisation de données ou en architecture. Vous pouvez trouver une collection de ressources discutant de l'impact de ces décisions dans la conclusion de cet article.
Note: Cet article affiche des captures d'écran de différents graphiques et journaux mais n'inclut pas de données d'exemple avec lesquelles travailler. Les graphiques utilisent différents ensembles de données et échelles et ne doivent pas être utilisés pour tirer des conclusions. Vous devez effectuer des tests avec vos propres données pour tirer des conclusions en utilisant les techniques décrites dans cet article. Les journaux montrés dans cet article proviennent d'ArcGIS Enterprise 12.1, donc les versions plus récentes ou plus anciennes peuvent afficher des messages différents. La formulation spécifique et la structure des fichiers journaux changent à chaque version, c'est pourquoi il est important que vous compreniez comment interpréter les journaux plutôt que de mémoriser des messages spécifiques.
Un autre point important à retenir de cet article est de réfléchir à la manière dont les journaux sont utilisés. Ils sont un outil important pour le dépannage, et ils peuvent également démontrer l'impact que les décisions de modélisation des données, la configuration ou même l'architecture peuvent avoir sur la performance et l'expérience utilisateur finale.
Les journaux serveur fournissent des informations détaillées qui vous permettent de mesurer la performance d'opérations spécifiques, et dans bien des cas aussi de corréler les impacts sur la performance à des sous-réseaux spécifiques ou au nombre d'entités impactées par cette opération. Par exemple, considérez la situation où un utilisateur se plaint que les sous-réseaux se mettent à jour trop lentement.
Une évaluation normale de la performance consisterait à exécuter l'opération update subnetwork sur tous les sous-réseaux du système, en utilisant un seul processus, pour créer un graphique montrant les temps de réponse retournés par ce serveur. Cela produit un graphique comme le suivant :
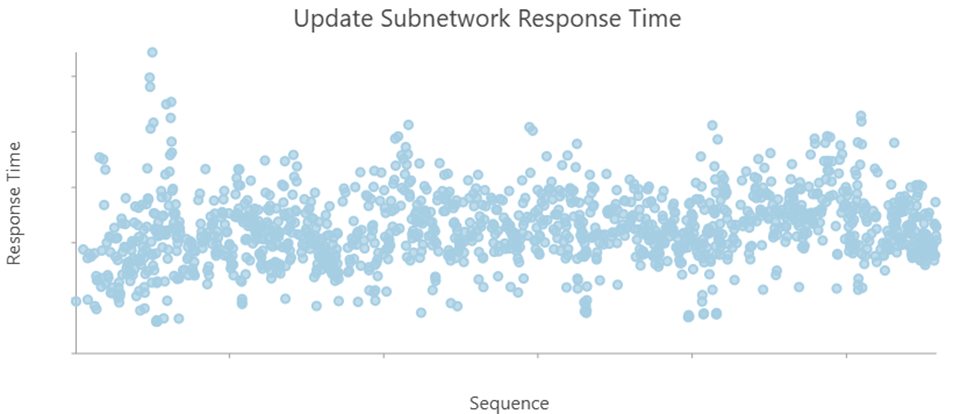
Bien qu'il soit intéressant de voir la distribution des temps de réponse, cela ne donne aucune indication sur pourquoi certaines réponses sont meilleures que d'autres, ni ce qui nécessite une enquête plus approfondie. Au lieu de cela, cette approche traite chaque réponse comme égale, ce qui n'est pas le cas pour les sous-réseaux. En analysant les fichiers journaux, vous pouvez produire des graphiques offrant une meilleure compréhension exploitable.
Une chose simple que vous pouvez faire pour identifier les sous-réseaux problématiques à examiner est de créer un graphique incluant le nom du sous-réseau extrait des journaux avec son temps de réponse.
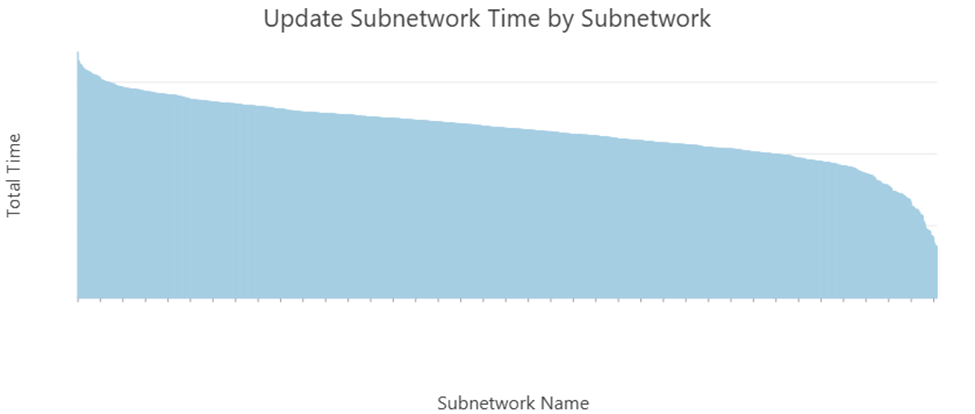
Cela vous permet de trouver un sous-réseau spécifique dans les données pour enquête tout en vous donnant une idée du comportement global du système. Cela facilite l'identification de vos sous-réseaux aux meilleures et pires performances ainsi que tout élément aberrant.
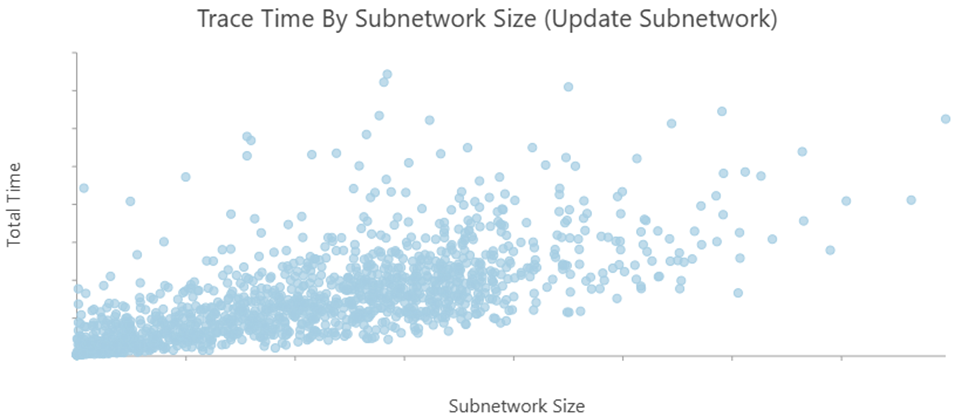
Avec un peu plus d'efforts, vous pouvez aussi extraire le nombre d'entités dans chaque sous-réseau depuis les fichiers journaux. Cela vous permet de créer un graphique utilisant le nombre d'entités dans chaque sous-réseau sur l'axe X.
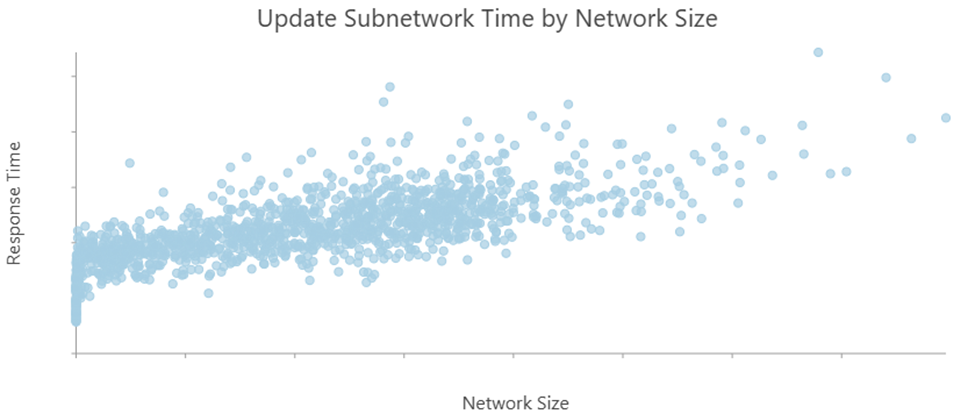
Ce graphique facilite la visualisation de la corrélation entre la taille du réseau et le temps de réponse. Cela indique que la plupart du temps, les sous-réseaux qui prennent plus longtemps à se mettre à jour sont plus grands. Il vous permet aussi de voir qu'il y a quelques petits réseaux qui prennent plus longtemps que prévu, ce qui vous permet de concentrer votre attention sur eux.
Vous pouvez pousser cette approche encore plus loin en extrayant des informations plus détaillées depuis les journaux pour voir les durées associées aux opérations spécifiques au sein de chaque sous-réseau.
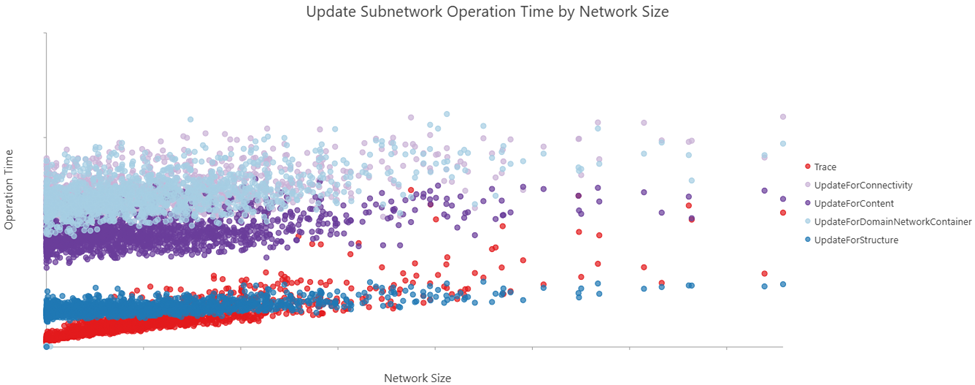
Ce graphique vous permet d'identifier les opérations et sous-réseaux qui prennent le plus de temps. Ces informations détaillées vous permettent d'enquêter sur quelles étapes peuvent être améliorées pour optimiser le temps de ces opérations spécifiques.
Dans cet article, vous apprendrez quelques considérations clés lors de l'interprétation des temps pour les journaux suivants :
- Tracing utilise le TraceLog
- Update Subnetwork utilise le UpdateSubnetworkLog
- Export Subnetwork utilise le ExportSubnetworkLog
- Enable Network Topology et Validate Network Topology utilisent le BuildLog
Avant d'aborder les journaux individuels, discutons de l'importance d'utiliser ces outils pour aider à isoler et dépanner les problèmes de performance.
Isolation des performances
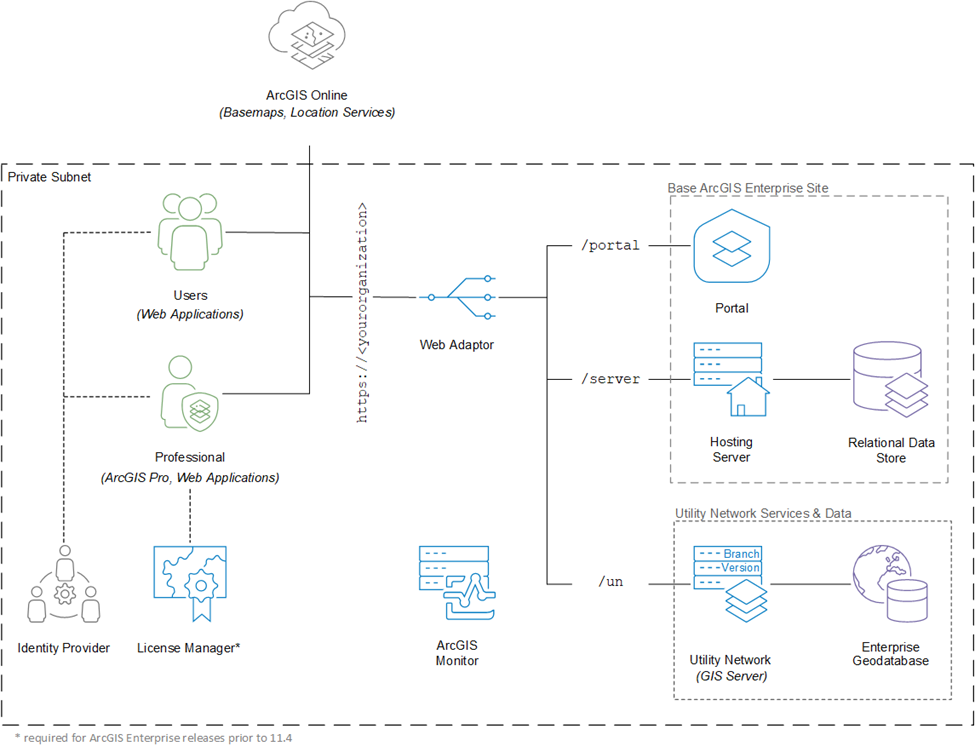
Lors du dépannage d'un problème de performance dans ArcGIS Enterprise, il est possible que ce problème soit causé par une grande variété d'éléments architecturaux, configurations ou même problèmes liés aux données. Si le problème que vous étudiez concerne la performance d'une seule opération dans le utility network qui ne nécessite pas la gestion des versions, une bonne façon de réduire le nombre de dépendances et isoler le problème est d'abord copier le utility network dans une nouvelle géodatabase mobile.
En travaillant avec une géodatabase mobile locale, vous pouvez vous concentrer sur la performance du utility network lui-même sans variables supplémentaires liées à l'architecture du déploiement ArcGIS Enterprise. Cela vous permet de focaliser sur un flux utilisateur unique sans versionnement.
La performance du utility network dans un environnement local n'est pas équivalente à celle dans un environnement entreprise. Cependant, cela permet néanmoins de déterminer si un problème de performance est causé par les données et la configuration du utility network ou par l'architecture et configuration de l'environnement.
Si le problème n'est pas reproductible en local, vous pouvez toujours utiliser les informations obtenues lors des tests locaux pour orienter votre enquête en entreprise. Vous pouvez comparer les temps et étapes détaillés entre la géodatabase locale et celle entreprise afin d'identifier si une étape prend plus longtemps. Cela pourrait indiquer un problème avec la base que vous pourrez approfondir en évaluant les plans performants via les outils disponibles pour votre SGBD.
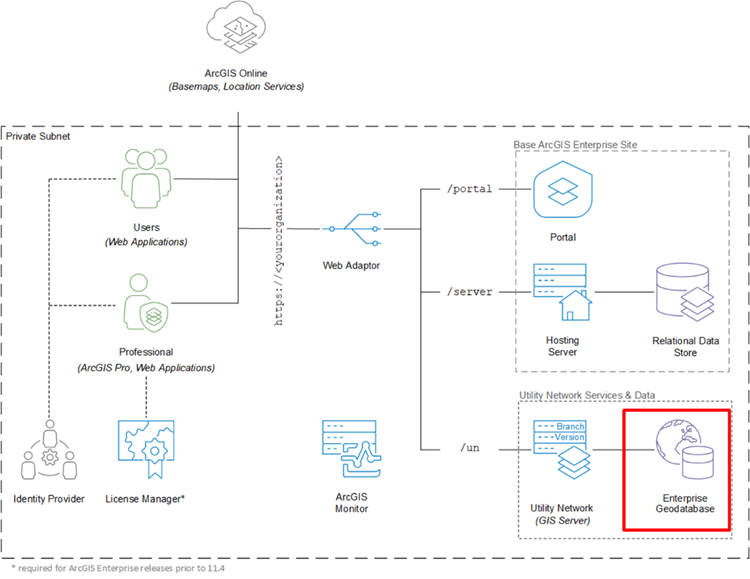
Vous pouvez aussi comparer le temps rapporté par chaque opération dans les logs ArcGIS Server avec ceux rapportés par le client. S'il existe des écarts importants ou incohérences entre ces temps, cela pourrait indiquer un problème de communication entre client et serveur. Les graphiques ci-dessous montrent quels temps sont capturés par différents journaux.
Mesurer le temps réponse client inclut le temps total passé à compléter la requête au niveau application, serveur et couche données dans l'architecture. Ceci n'est souvent pas utile pour identifier la cause profonde d'un problème mais reste important pour comprendre pleinement le contexte et flux nécessaires à reproduire ce problème.
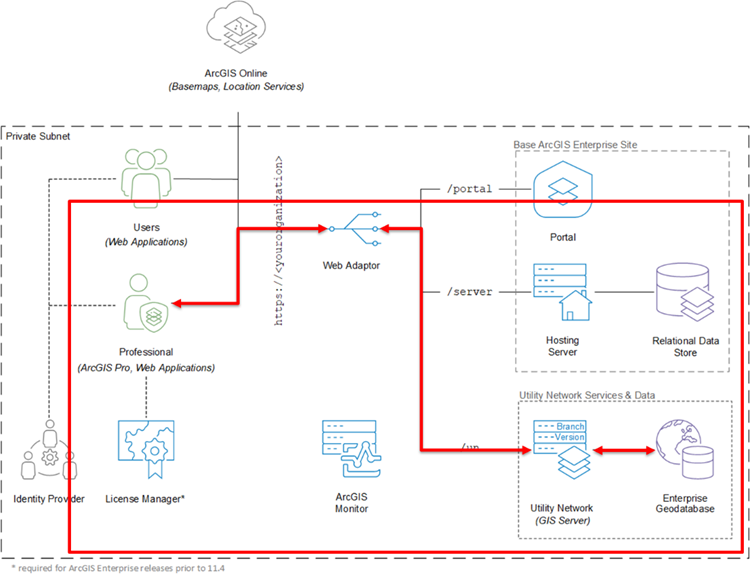
Les logs ArcGIS Server permettent quant à eux de se concentrer sur le temps passé au niveau serveur et couche données tout en fournissant aussi le contexte pour chaque requête ainsi que son temps d'exécution.
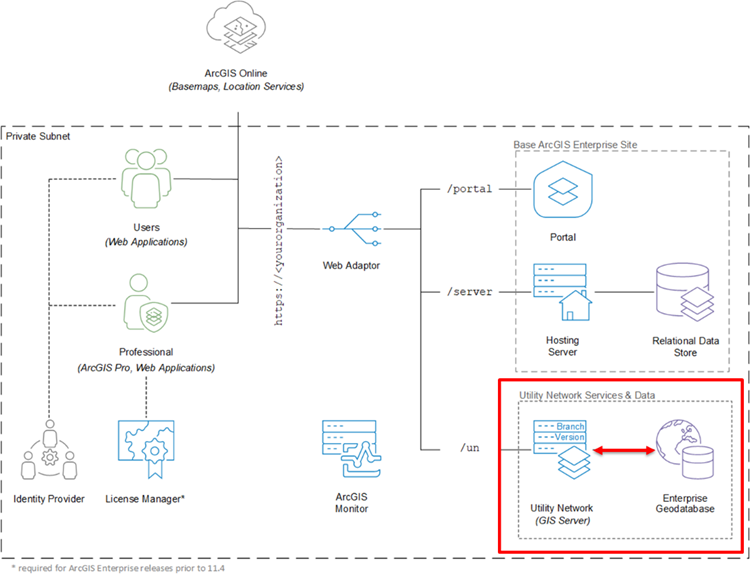
Examiner la performance au niveau base fournit également une bonne vision sur certains problèmes liés aux bases mais manque du contexte client ou application.
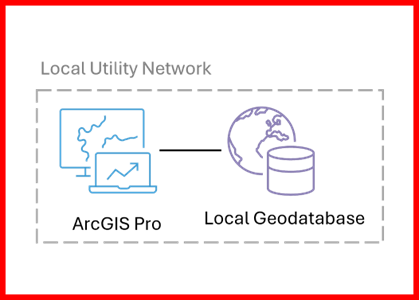
Copier les données vers une géodatabase mobile locale puis capturer les logs via Diagnostic Monitor dans ArcGIS Pro est une méthode puissante pour isoler les problèmes performants car elle permet contrôler flux et contexte pour chaque opération tout en mesurant sa performance avec peu dépendances possibles. Vous trouverez ci-dessous un schéma illustrant ce scénario.
Maintenant que vous comprenez comment et pourquoi isoler ces problèmes lors des tests, nous allons voir comment analyser les logs du utility network afin d'obtenir des informations sur la performance.
Trace Log
Le Trace Log comporte quatre sections importantes :
- Environnement
- Paramètres du trace
- Étapes et durées
- Statistiques index réseau
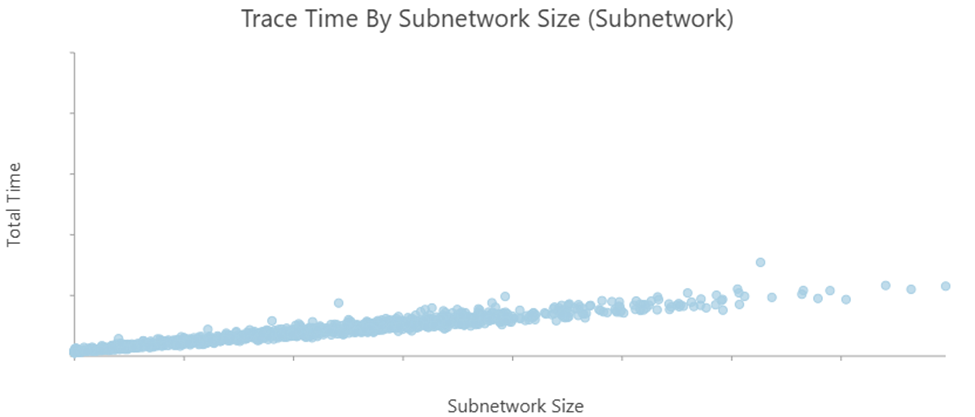
Pour évaluer globalement la performance d'un système, il est courant d'examiner le temps total pris par chaque trace comparé au nombre d'éléments retournés. Le scénario test classique consiste à exécuter une trace subnetwork pour chaque sous-réseau dans le utility network puis mesurer son temps contre le nombre d'éléments dans chaque sous-réseau.
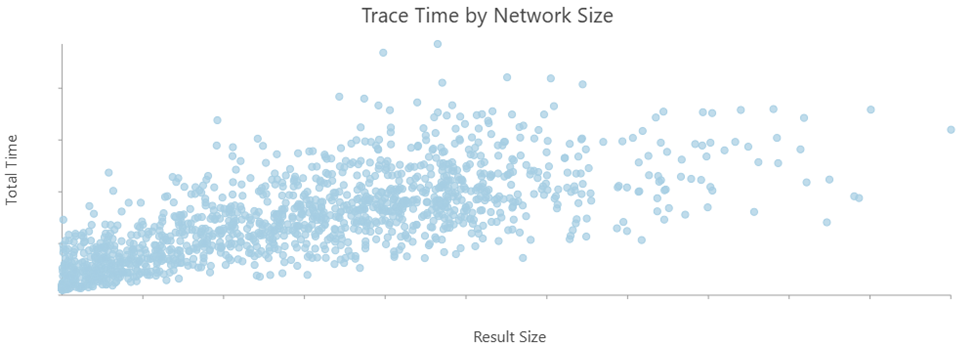
La trace sur un même sous-réseau retournera différents résultats selon qu'il s'agit d'une trace configurée par l'utilisateur ou celle utilisée par export subnetwork ou update subnetwork. Lorsqu'on mesure la performance des traces, on doit regarder celle des traces subnetwork selon votre configuration standard durant update subnetwork. Si vous prévoyez utiliser export subnetwork, planifiez aussi mesurer la performance durant export subnetwork selon votre configuration attendue.
Quand un sous-réseau particulier présente une mauvaise performance, vous pouvez alors examiner le temps associé aux étapes individuelles pour chaque sous-réseau versus leur nombre d'éléments.
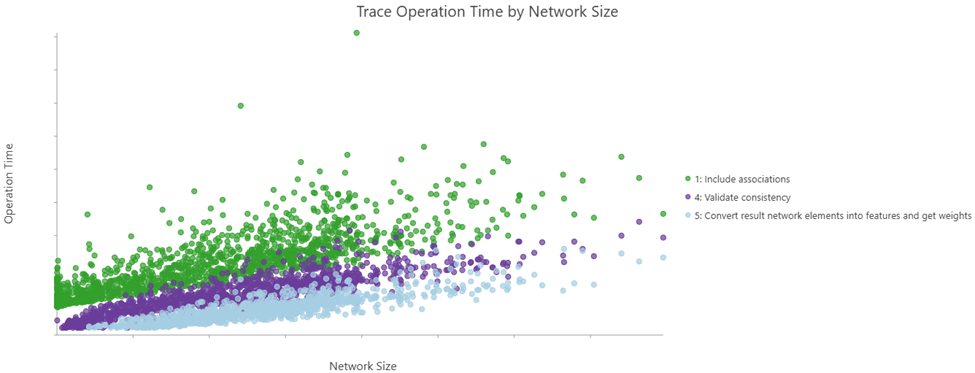
En examinant les différentes étapes associées à une opération de trace, vous commencerez à comprendre pourquoi certaines traces prennent plus de temps, et l'impact significatif que la configuration d'une trace a sur la performance globale.
Par exemple, si vous utilisez un graphique comme celui-ci pour analyser la performance d'une trace après avoir ajouté des fonctions ou des types de résultats spécifiques, vous pourrez mesurer le coût en performance de ces changements spécifiques, chacun affiché comme sa propre opération avec un coût associé.
Paramètres d'environnement et de trace
La section de configuration vous aide à comprendre le contexte de la trace. Elle communique le type de trace, la version, les points de départ et la configuration de la trace, ainsi que les types de résultats spécifiés pour la trace. Tous ces paramètres affectent le comportement de la trace. Modifier l'un d'eux produirait un résultat différent et pourrait affecter la performance.
Étapes et temps
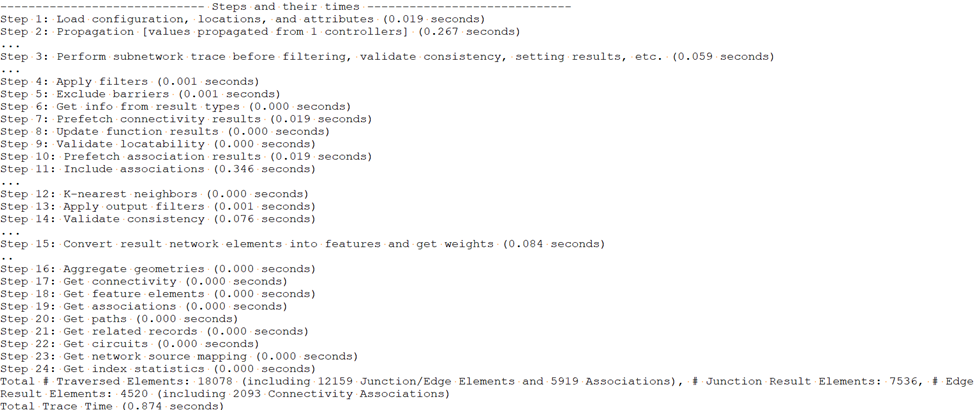
Cette section du journal inclut des informations détaillées sur toutes les opérations effectuées pendant la trace, et combien de temps chacune a pris. Certaines étapes incluent également des informations sur le nombre d'entités impliquées dans cette étape de la trace.
Lors de l'analyse du temps, la première chose à faire est de regarder combien de temps la trace totale a pris, puis vous devez examiner la taille des résultats. Le nombre d'éléments parcourus et retournés se trouve à la fin des étapes et temps avec les lignes suivantes :

Le Temps Total de Trace est facile à comprendre ; c'est le temps total pris pour effectuer la trace. Le nombre d'éléments découverts nécessite un peu plus de réflexion car il inclut le nombre d'éléments parcourus ainsi que le nombre d'éléments dans le résultat.

Ceci est important car beaucoup de traces parcourront beaucoup d'éléments mais ne retourneront qu'un sous-ensemble des résultats. Même si un petit nombre d'entités peut être retourné, la trace peut nécessiter l'analyse de nombreuses entités. Des exemples incluent les traces en amont ou en aval, les traces avec une barrière filtrante configurée, ou les traces exécutées lors de la mise à jour du sous-réseau pour découvrir des entités dans plusieurs sous-réseaux. Pour cette raison, les éléments parcourus sont souvent un meilleur indicateur de performance que la taille du résultat.
Vous voudrez également examiner les étapes individuelles et leurs durées pendant la trace. Ces détails vous montreront où le temps est passé durant la trace.
Statistiques de l'index réseau
Les statistiques de l'index réseau vous indiquent combien d'informations réseau ont été chargées depuis la base de données pendant l'analyse. Ces journaux sont généralement utilisés uniquement par le support et le développement pour diagnostiquer des problèmes spécifiques.
Cette section contient les statistiques suivantes :
- Statistiques de la table topologie – Un résumé du nombre de lignes lues dans la topologie réseau.
- Statistiques des tables d'associations – Un résumé du nombre d'associations lues.
- Statistiques du moteur de poids – Un résumé du nombre d'attributs réseau lus.
- Statistiques du gestionnaire mémoire – Un résumé de la mémoire utilisée.
Si vous choisissez d'examiner les statistiques dans ce rapport, vous remarquerez peut-être que tous les attributs réseau ne sont pas reportés dans la section des statistiques du moteur de poids. Cela est dû au fait que les attributs réseau stockés en ligne sont stockés à l'intérieur des tables topologie et sont inclus lorsque la connectivité pour l'entité est accédée depuis la base de données. Chaque attribut réseau hors ligne lu depuis l'index réseau a un petit coût associé, généralement pas plus que quelques millisecondes pour un petit réseau. Cependant, lorsque beaucoup d'attributs hors ligne sont lus, ou lorsque le réseau est beaucoup plus grand, ce coût peut devenir notable.
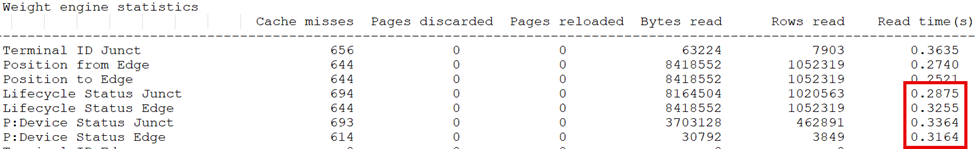
C'est pourquoi vous devriez envisager de stocker les attributs réseau nécessaires pour la plupart de vos traces en ligne, en particulier ceux référencés par votre définition de sous-réseau. Pourquoi tous les attributs réseau ne sont-ils pas stockés en ligne ? Parce qu'il y a une quantité limitée d'espace disponible pour les attributs réseau en ligne, vous devez donc décider quels attributs sont les plus importants et vous assurer qu'ils sont stockés en ligne. Vous remarquerez également que les attributs réseau stockés en ligne n'apparaissent pas dans les statistiques de l'index réseau.
Lorsque vous essayez de comparer les résultats entre deux tests, vous pouvez également regarder les échecs du cache pour déterminer combien était disponible en mémoire (en cache) par opposition aux lignes lues depuis la base de données.
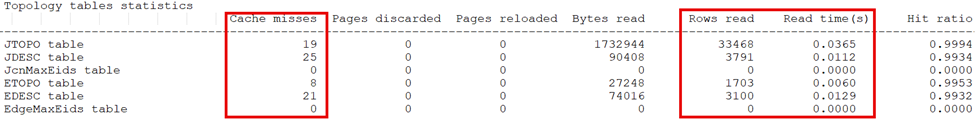
Lorsque vous comparez les performances entre différentes traces ou opérations, il est important de prêter attention au nombre d'échecs du cache. Une trace exécutée entièrement depuis la mémoire (cache chaud) fonctionnera mieux que la même trace qui doit charger des informations de connectivité depuis la base de données (cache froid).
Il n'y a pas grand-chose que vous puissiez faire pour contrôler cela dans les flux utilisateurs, mais il est important d'en tenir compte lors de l'établissement d'une méthodologie cohérente pour tester afin que vous puissiez comparer précisément les résultats des différents tests. La manière la plus prudente et cohérente pour mesurer les résultats est de s'assurer que tous les tests sont effectués avec un cache froid.
Journal Mise à jour Sous-réseau
Lorsqu'on évalue la performance de mise à jour sous-réseau, il faut commencer par examiner le Journal Mise à jour Sous-réseau créé pendant l'opération. De plus, il est souvent utile d'examiner le Journal Trace associé à chaque sous-réseau, car cela peut souvent expliquer une grande partie du temps passé à mettre à jour un sous-réseau.
Note : En examinant le Journal Trace pour mise à jour sous-réseau, vous pouvez remarquer que les étapes et temps diffèrent par rapport à une simple exécution d'une trace. Cela dépendra de votre configuration réseau, mais vous verrez plus de temps passé à trouver des éléments dans plusieurs sous-réseaux (pour réseaux avec propagation), du temps passé à récupérer la géométrie pour calculer la ligne du sous-réseau ainsi que du temps passé à calculer des fonctions pour la ligne agrégée.
Comme pour le Journal Trace, il y a trois sections dans le journal mise à jour sous-réseau.
- Environnement
- Paramètres du Sous-réseau
- Étapes et temps
- Statistiques index réseau
Lorsqu'on évalue la performance mise à jour sous-réseau, on considère les informations suivantes :
- Combien de temps a pris la mise à jour du sous-réseau ?
- Quelle était la taille du sous-réseau mis à jour ?
- Combien d'entités ont été mises à jour ?
Les deux premiers sont facilement trouvables dans le journal ; le dernier nécessite une lecture approfondie pour savoir combien d'entités ont changé.
Lorsqu'on évalue la performance globale du système, on regarde généralement le temps nécessaire pour mettre à jour chaque sous-réseau dans le système par rapport au nombre d'entités dans ce sous-réseau.
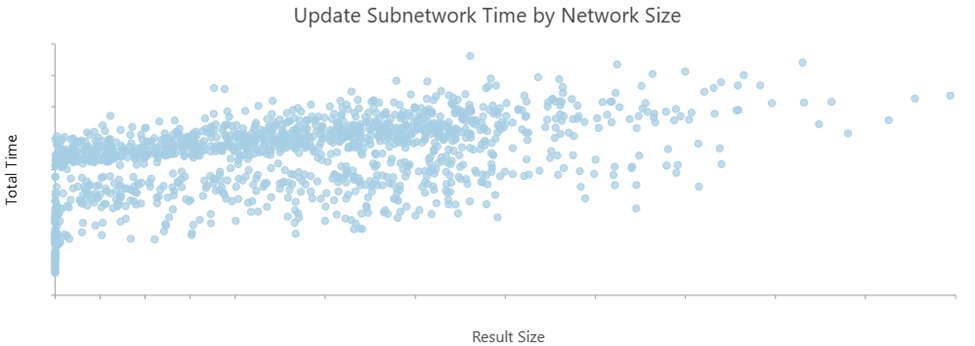
Lorsqu'on effectue cette analyse, on peut considérer trois scénarios différents :
- Combien de temps prend la première opération mise à jour sous-réseau ?
- Combien de temps prend une mise à jour sous-réseau quand rien n'a changé ?
- Combien de temps prend une mise à jour sous-réseau quand un nombre raisonnable d'entités ont changé ?
Vous voudrez généralement vous concentrer sur le temps nécessaire pour exécuter mise à jour sous-réseau avec un nombre raisonnable d'éditions, car c'est ce que les utilisateurs expérimenteront dans leur flux quotidien. La première mise à jour est importante car elle est celle qui prend le plus longtemps et doit être effectuée lors du déploiement du système. Le scénario sans changement est intéressant car c'est le meilleur cas possible en termes de performance.
Lorsque vous trouvez un sous-réseau qui fonctionne mal, vous pouvez examiner le temps des étapes individuelles pour identifier s'il y a une étape particulière qui prend majoritairement le temps.
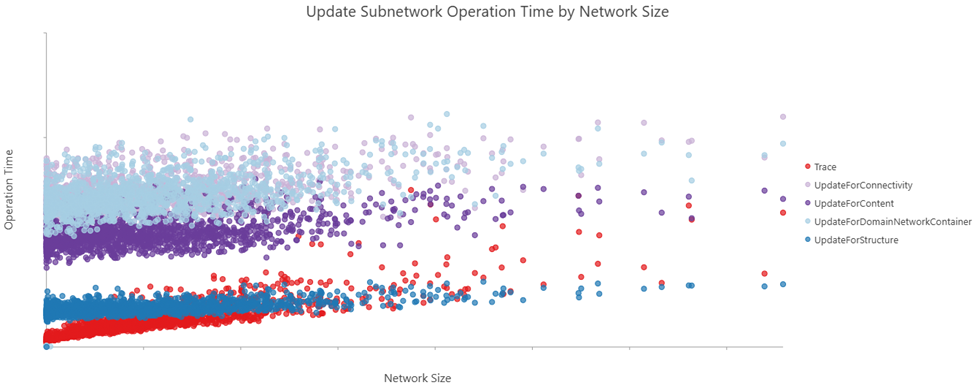
Si vous comparez le temps passé à exécuter une trace pendant une opération mise à jour sous-réseau avec une trace normale sur un sous-réseau, vous constaterez généralement que celle exécutée pendant mise à jour sous-réseau prend plus longtemps. Cela s'explique par le travail supplémentaire effectué lors de mise à jour sous-réseau pour charger les géométries afin d'agréger, calculer des fonctions sommaires et parfois trouver des éléments dans plusieurs sous-réseaux.
Paramètres Environnement et Sous-réseau
En examinant la section configuration du journal, portez une attention particulière aux configurations suivantes :
- Nom Version
- Mode Édition
- Nom Niveau
Le nom version et mode édition sont importants car le comportement et le temps nécessaire pour mettre à jour un sous-réseau peuvent varier selon le mode édition utilisé et si cela s'est produit dans une version par défaut ou nommée. Vous pouvez en apprendre davantage sur ces considérations dans l'article Comprendre les Sous-réseaux : Mode édition. En bref, lorsque le mode édition est réglé sur « avec événements », vous subissez des coûts supplémentaires liés aux règles d'attributs ; lorsque le mode édition est « sans événements » désactivé dans une version nommée, il se peut que toutes les entités du sous-réseau ne soient pas mises à jour.
Il est aussi important de considérer le nom niveau lors de l'examen des performances car la configuration trace du niveau contrôle le comportement mise à jour sous-réseau concernant la création ou mise à jour d'une ligne sous-réseau, diagrammes réseau, etc.
Étapes et temps
En regardant les étapes et durées, vous êtes principalement concerné par les sections suivantes :
- Trace
- Les différentes étapes mises à jour (Connectivité, Contenu, etc.)
- Gestion de la ligne sous-réseau
- Gestion des diagrammes réseau
- Total
Vous regarderez Trace pour voir combien de temps elle a pris et surtout combien d'entités ont été découvertes comme faisant partie du sous-réseau.
Ensuite vous examinerez combien de temps a été passé à mettre à jour divers attributs dans la base qui suivent l'information persistante du sous-réseau (nom du sous-réseau, connecté ou non, etc.).
Le temps passé à gérer la ligne sous-réseau et les diagrammes réseau est généralement relativement faible. Mais lorsqu'ils prennent beaucoup trop longtemps il peut être nécessaire d'examiner leur configuration respective.
La ligne Total indique le temps total qu'a pris mettre à jour le sous-réseau.
Statistiques index réseau
Les considérations pour examiner les statistiques index réseau lors mise à jour sous-réseau sont identiques au Journal Trace.
Journal Exportation
Lorsqu'on évalue la performance export subnetwork on considère trois choses :
- Quels types résultats, attributs etc. ont été exportés ?
- Combien a-t-il fallu pour obtenir toutes les informations demandées par la trace afin qu'elles soient exportées ?
- Combien a-t-il fallu pour générer le fichier ?
Pour répondre à ces questions, vous consulterez principalement le Journal d'Exportation. Un TraceLog est généré pour la trace exécutée dans le cadre de l'opération d'exportation du sous-réseau si vous avez besoin d'une analyse plus détaillée du temps passé lors de cette opération.
Le Journal d'Exportation comporte cinq sections différentes :
- Environnement
- Paramètres du sous-réseau
- Paramètres d'exportation
- Étapes et leurs durées
- Statistiques de l'index réseau
Lors de l'évaluation des performances globales de l'exportation du sous-réseau, vous souhaitez comparer le temps nécessaire pour exécuter l'exportation du sous-réseau avec le nombre d'entités exportées. Cependant, contrairement au TraceLog et à l'UpdateSubnetworkLog, il ne comprend pas le nombre d'entités retournées par la trace.
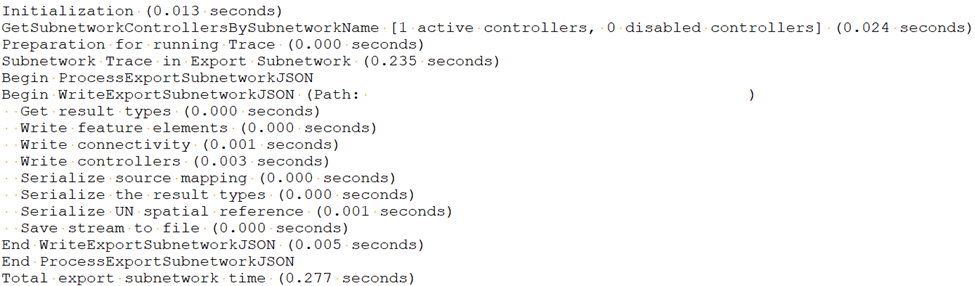
Le nombre d'entités peut toutefois être extrait du TraceLog.

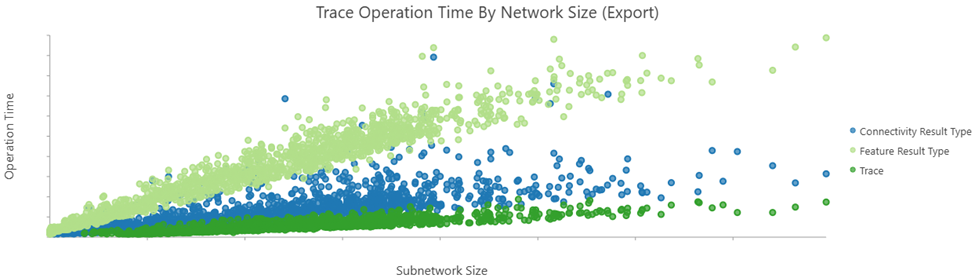
Lorsque vous constatez qu'un sous-réseau fonctionne mal lors de l'opération d'exportation, vous voudrez examiner où le temps est passé dans le journal d'exportation. Si la majeure partie du temps est consacrée à la trace, alors vous devrez consulter le journal de trace. Dans ce cas, il est souvent utile de comparer ce temps avec celui passé lors d'une trace normale dans un sous-réseau (qui n'inclut aucun type de résultat ni fonction).
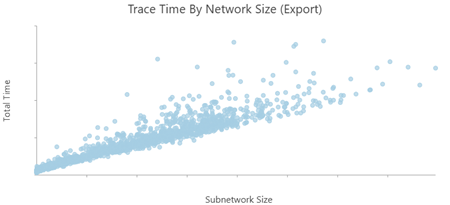
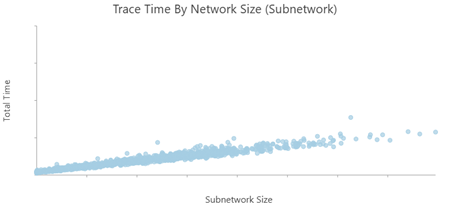
Cette méthode vous permet d'identifier combien de temps est passé pendant la trace dans l'exportation du sous-réseau pour obtenir chaque type de résultat (connectivité, éléments d'entité, etc.) ainsi que le temps total passé à exécuter la trace. La trace lors de l'exportation prend toujours plus de temps qu'une trace normale car elle doit lire des informations supplémentaires depuis la base de données. Examiner les détails du journal de trace pendant l'exportation vous permet de voir combien de temps est consacré à chaque type de résultat.
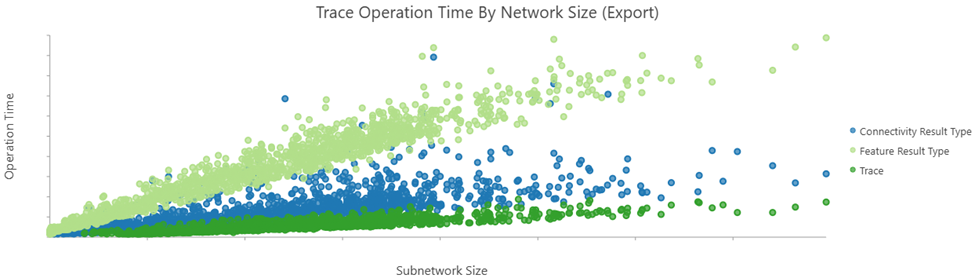
C'est pourquoi il est important que vous n'exportiez que les attributs et autres informations nécessaires, car le coût d'exporter des informations inutiles peut être élevé.
Environnement et paramètres
L'exportation du sous-réseau offre de nombreuses options qui contrôlent ce que vous pouvez exporter. Cependant, plus vous incluez d'informations dans l'exportation, plus la trace utilisée pour rassembler toutes ces informations prendra du temps. Plus vous incluez d'informations dans l'exportation, plus les fichiers seront volumineux et plus leur génération et téléchargement prendront du temps.
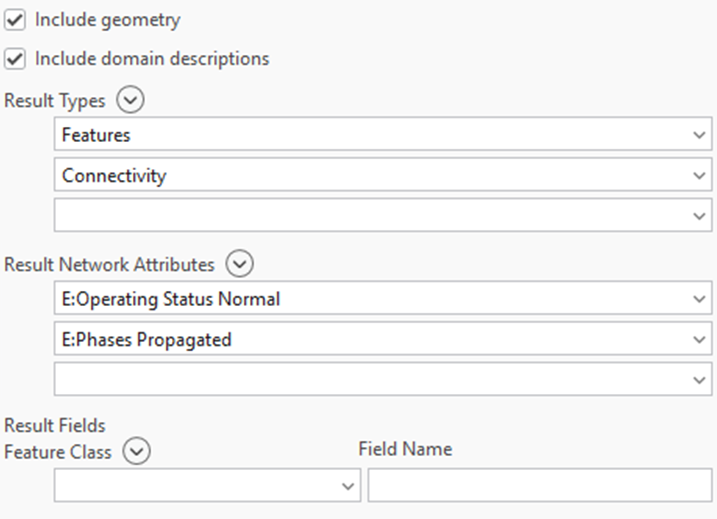
Vous pouvez voir quelles informations un utilisateur a spécifié pour inclure dans son export en regardant la section des paramètres d'exportation du rapport. Cela vous permet de voir quels types de résultats ont été inclus ainsi que combien d'attributs réseau, champs de résultats (pour les entités) et champs d'enregistrements liés (pour les enregistrements liés) ont été sélectionnés.
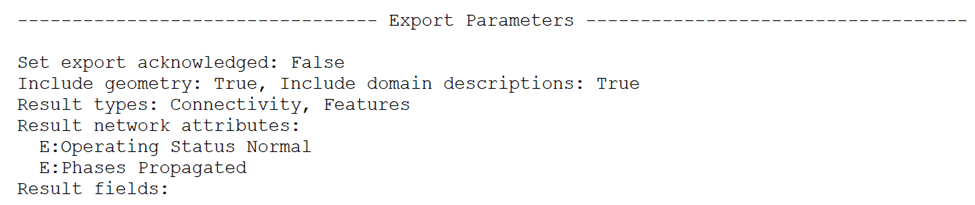
Inclure beaucoup d'attributs provenant des entités et des enregistrements liés nécessite des requêtes supplémentaires à la base de données, ce qui peut ajouter du temps à la trace pour obtenir ces informations. De plus, sélectionner beaucoup d'attributs peut augmenter considérablement la taille du fichier. Inclure tous les attributs réseau pour un sous-réseau peut doubler la taille du fichier et le temps nécessaire pour exporter le sous-réseau. Inclure des attributs provenant de nombreuses tables différentes aura un effet négatif encore plus important sur les performances.
Étapes et durées
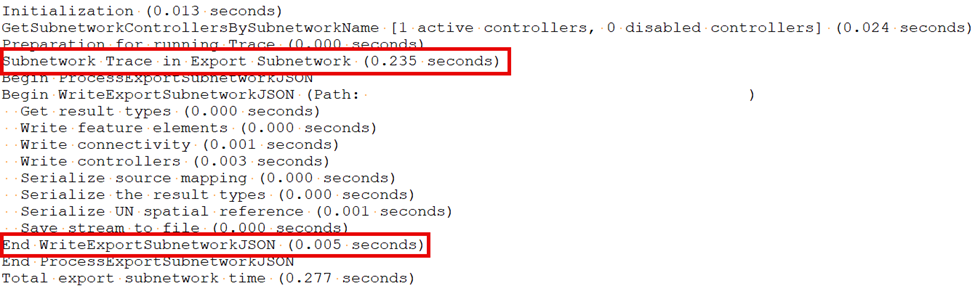
Il y a moins d'étapes à analyser dans le journal d'exportation du sous-réseau. Dans la plupart des cas, la trace sera le poste le plus coûteux lors de l'exportation du sous-réseau. Cependant, si vous voyez une grande quantité de temps passée sur les étapes Process/Write JSON, cela indique que le fichier est volumineux et prend beaucoup de temps à sérialiser, télécharger et enregistrer.
Statistiques de l'index réseau
Les considérations pour examiner les statistiques de l'index réseau pour l'exportation du sous-réseau sont les mêmes que pour le Trace Log.
Journal de construction
Le format du journal de construction diffère des autres journaux diagnostiques du réseau utilitaire car il est conçu comme un journal incrémental généré durant des sessions potentiellement longues. Pour cette raison, chaque ligne dans le journal indique le temps nécessaire pour compléter l'étape, le temps total écoulé jusqu'à ce point et la mémoire utilisée à ce moment-là.
Le même format de fichier journal est utilisé pour les trois opérations de construction :
- Activer la topologie réseau
- Désactiver la topologie réseau
- Valider la topologie réseau
De ce fait, vous pouvez remarquer que la numérotation des étapes dans certains journaux semble sauter certaines étapes. Cela s'explique par le fait que toutes les étapes ne s'appliquent pas à toutes les opérations.
Lors de l'examen des journaux, concentrez-vous sur les sections suivantes
- Environnement
Étapes et leurs durées
- Configuration de la construction du réseau
- Traitement post-construction
- Statistiques de l'index réseau
Lors de l'évaluation des performances, considérez quel type de construction a lieu, combien d'attributs réseau sont traités, quelle quantité de mémoire/disque disponible existe, si une analyse a été effectuée pour identifier les sous-réseaux affectés par la validation (traitement post-construction), et combien d'entités sont traitées. La plupart de ces informations se trouvent dans les sections environnement et configuration de construction du réseau du journal.
Pour Activer ou Désactiver la topologie réseau, vous devez principalement surveiller le débit, l'utilisation mémoire et celle du disque. Plus vous pouvez compter sur la mémoire pour construire la topologie réseau, plus cela ira vite ; mais pour les grands ensembles de données cela n'est pas réaliste. Dans ces cas-là, la construction commencera à écrire des informations sur disque ; il faudra alors s'assurer que le disque configuré est rapide (idéalement un SSD) et qu'il y a suffisamment d'espace disque pour contenir les fichiers temporaires.
Pour Valider la topologie réseau, votre principale préoccupation est le temps total nécessaire à la construction du réseau puisque c'est généralement un utilisateur qui lance cette validation et vous souhaitez minimiser son attente. Si vous constatez un long temps passé au traitement post-construction, alors il sera utile que vous consultiez l'article Comprendre le statut des sous-réseaux. Ce comportement est contrôlé par la définition du sous-réseau pour chaque niveau dans le réseau et peut être modifié même après avoir déployé votre réseau utilitaire. Les réseaux utilitaires configurés pour maintenir un champ statut sur leurs sous-réseaux doivent effectuer un traitement post-construction lors de Valider la topologie réseau afin d’identifier les sous-réseaux affectés par cette validation afin qu’ils puissent être marqués comme modifiés.
Environnement et configuration de construction du réseau
L'étendue validée est indiquée dans la section environnement du journal de construction ; cette étendue n'a vraiment un sens que lors de l'évaluation de Valider la topologie réseau. En effet, Activer ou Désactiver la topologie réseau s'exécutent toujours sur toute l'étendue complète du réseau.
Les étapes de construction du réseau ainsi que le nom du fichier journal indiquent le type de construction réalisée. Vous pouvez aussi voir combien d'attributs réseau, mémoire et espace disque étaient disponibles au démarrage du processus. Si la mémoire utilisée dépasse celle disponible pendant la construction, alors le processus commencera à écrire sur disque et deviendra plus lent.
Étapes et leurs durées
Il y a plusieurs étapes durant le processus de construction du réseau ; bien qu'elles ne soient pas toutes décrites ici, gardez en tête les points suivants lors de votre examen des journaux :
- Quelle quantité d'informations a été traitée durant cette étape ?
- Quelle quantité d'informations a été créée durant cette étape ?
- Combien de temps/mémoire cette étape a-t-elle utilisé ?
Chaque étape rapporte généralement le temps total nécessaire à son achèvement dans son dernier message.
Vous pouvez trouver le temps total pris par toute l'opération en regardant la dernière ligne du fichier journal.
Pour identifier la mémoire utilisée, comparez la mémoire totale indiquée lors du premier message logué pour l'étape avec celle indiquée lors du dernier message logué pour cette étape.
Statistiques de l'index réseau
Puisque le processus de construction remplit l’index réseau, cette section peut être intéressante pour comprendre combien d’informations les tables système ont lu, écrit ou créé durant ce processus. Cependant, une fois votre réseau utilitaire déployé, il n’y a pas grand-chose que vous puissiez faire pour influencer ces chiffres.
Si vous êtes au début d’un projet, vous pourrez voir les impacts liés au nombre d’attributs réseau dont vous disposez et profiterons-en pour vérifier que tous ceux-ci sont nécessaires dans votre modèle. Si certains attributs ne sont pas nécessaires aux workflows et que vous êtes encore au début du projet où ils peuvent être retirés du modèle, envisagez cette option. Vous pouvez toujours ajouter un attribut réseau ultérieurement mais une fois déployé il ne peut plus être supprimé.
Si vous hésitez entre continuer à modéliser des enregistrements liés comme tels ou bien comme objets non spatiaux avec connectivité et/ou contenance, vous pourrez voir ici combien il faut de temps pour construire un réseau intégrant ces objets non spatiaux supplémentaires.
Conclusion
Maintenant que vous avez lu cet article, vous devriez être familier avec l’interprétation des journaux des quatre principales opérations du réseau utilitaire. Vous pouvez commencer à réaliser des tests performance et interpréter les résultats en détail. Lorsqu’il s’agira de concevoir votre architecture et prendre des décisions importantes en modélisation des données, vous pourrez mesurer leur impact sur vos performances.
Pour une approche plus systématique afin capturer et mesurer les chiffres performance, vous pourriez utiliser un outil tel que Extract Log Files, qui combine les journaux dans une base données. Les graphiques présentés dans cet article ont été créés grâce à une méthode où les chiffres performance étaient extraits via expressions régulières depuis chaque fichier journal puis utilisés pour créer des visualisations.
Ces fichiers journaux sont importants car ils fournissent une mesure précise du temps pendant lequel le serveur exécute certaines opérations spécifiques. Ils sont extrêmement précieux pour évaluer une opération unique ; cependant ils ne donnent pas une vue complète. L’analyse performance doit être holistique afin qu’elle prenne en compte non seulement celle du réseau utilitaire mais aussi l’impact global sur toute l’architecture ainsi que comment le système se comporte sous charge.
Pour des exemples adoptant une approche plus globale aux tests et conception, consultez le Centre Architecture ArcGIS.
Pour voir comment modéliser les enregistrements liés peut affecter les performances, référez-vous à l’article Modélisation des données liées dans un réseau utilitaire.
Pour des exemples de la manière dont la configuration du mode édition de votre sous-réseau peut affecter les performances de mise à jour du sous-réseau, lisez le Understanding Subnetwork Edit Mode article.
Pour des exemples de la manière dont la configuration de gestion du statut de votre sous-réseau peut affecter les performances de validation de la topologie réseau, lisez le Understanding Subnetwork Status article.