Als je de Agriculture SIG van vorige week op Esris 2025 User Conference hebt gemist, hier is een korte samenvatting: De sessie, geleid door Mark Dann, Dr. Elvis Takow en mijzelf van Esri, bevatte presentaties over ArcGIS als een Artificial Intelligence (AI) Platform en hoe AI opnieuw te richten op Agriculture Intelligence. Daarna was er een paneldiscussie met vertegenwoordigers van AC Foods, Land OLakes en Texas A&M.
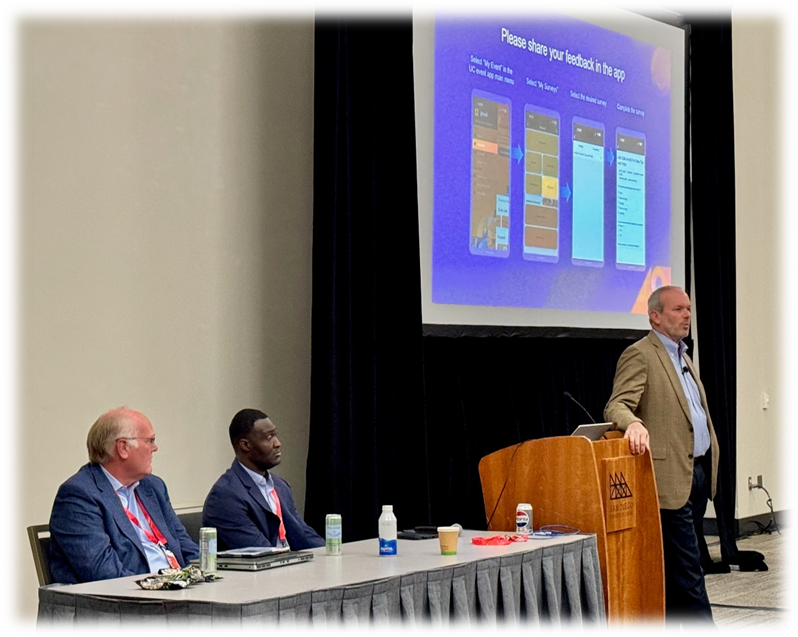
Het ArcGIS AI Platform door Dr. Takow
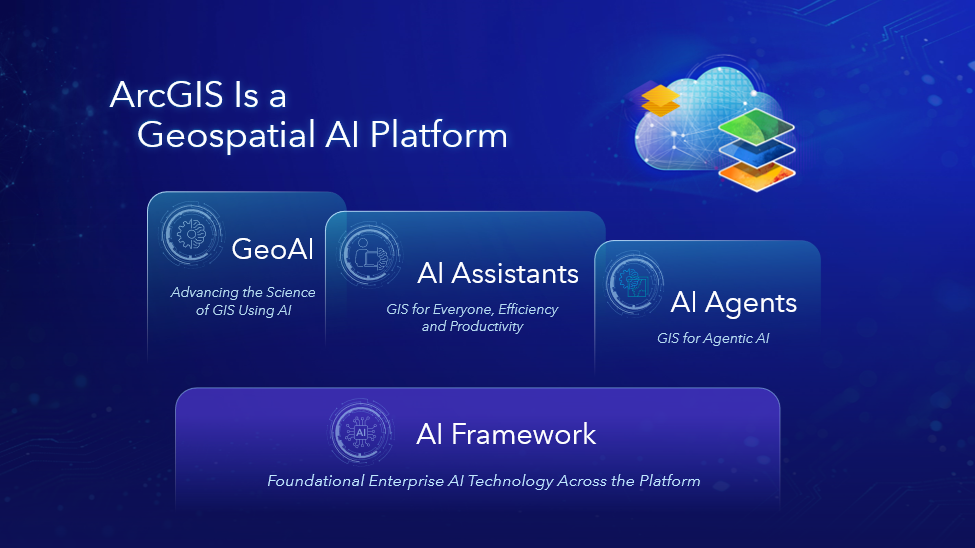
Als samenvatting van vele sessies op de conferentie presenteerde Dr. Takow ArcGIS als een geospatiaal AI-platform dat kunstmatige intelligentie gebruikt om de productiviteit te verhogen, besluitvorming te ondersteunen en innovatie aan te drijven. De drie hoofdcomponenten zijn:
- GeoAI-analyse voor geautomatiseerde data-creatie, extractie en analyse,
- AI-assistenten met conversatieinterfaces om workflows te stroomlijnen,
- Een onderliggend AI-framework dat beide functies ondersteunt.
Om deze technologische visie te realiseren, werkt Esri haar AI-functies bij met Assistants, Skills, Agents en vooraf getrainde modellen. Het platform is ontworpen om uitbreidbaar en aanpasbaar te blijven voor verschillende industrieën en behoeften. Het framework maakt ook integratie van AI, deep learning en large language models mogelijk, terwijl het ontwikkelaars ondersteunt bij het creëren van aangepaste AI-diensten en integraties.
De uitdaging voor de Agriculture GIS-gemeenschap zal zijn om zorgvuldig een breed scala aan mogelijkheden te introduceren in een sector die moet slagen gezien de constante druk om voedselvoorziening voor een groeiende bevolking te produceren. Daarvoor hebben we Agriculture Intelligence nodig, zoals besproken in de volgende sectie.
Agriculture Intelligence door Nick Short
Hoewel we hebben gehoord dat ArcGIS een belangrijk Geospatial AI Platform is voor innovatie, hoe kan dat de landbouw helpen? Deze presentatie legde kort uit hoe AI op de juiste en relevante manier benaderd kan worden, waarom nu het juiste moment is, hoe we fouten uit het verleden kunnen vermijden en hoe Esri's ervaring en langdurigheid de landbouwsector ten goede komt.
Bij het overwegen van de integratie van artificial intelligence (AI) binnen de landbouwsector is het relevant om de vraag te stellen: Wat definieert AI voor Agriculture? Deze vraag nodigt uit tot voortdurende dialoog over de evoluerende rol van AI in de landbouwpraktijk, zowel nu als in de komende jaren.
Een centraal concept moet voorop blijven staan in deze discussie: vertrouwen.
Voor de landbouwsector is vertrouwen van het grootste belang, vooral in de context van opkomende technologies zoals AI. Producenten en belanghebbenden begroeten technologische innovatie vaak met scepsis en uiten zorgen over gegevensprivacy, beveiliging en de complexiteit of bruikbaarheid van nieuwe systemen. Bovendien versterken de aanhoudende economische druk in de sector de noodzaak voor betrouwbaarheid en zekerheid voordat brede adoptie kan plaatsvinden.
De kernuitdaging is dus om te bepalen hoe de landbouwsector de adoptie van AI-technologien zal navigeren op een manier die vertrouwen binnen de gemeenschap bevordert en behoudt.
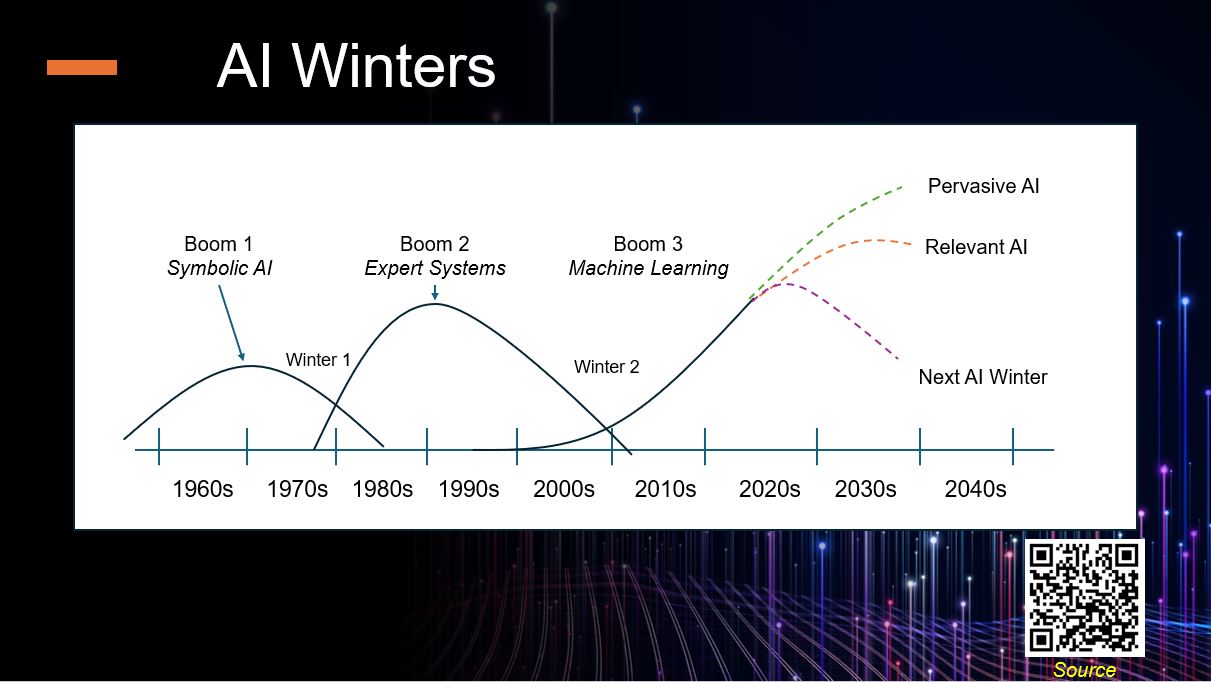
Het bestuderen van de geschiedenis van AI biedt inzichten in patronen van vertrouwen en adoptie binnen industrie.
Helaas wordt de ontwikkeling van AI gekenmerkt door afwisselende periodes van groei en neergangvaak aangeduid als AI Winterswaar verwachtingen niet werden waargemaakt, wat leidde tot fasen van teleurstelling.
In de jaren 80 genoot AI een opleving in populariteit, waarbij grote overheidsorganisaties investeerden in artificial intelligence om menselijke kennis vast te leggen in expert systemen. AI werd gezien als een veelbelovend hulpmiddel om grootschalige uitdagingen aan te pakken, waaronder klimaatveranderingsonderzoek en precisielandbouw. Deze periode werd gekenmerkt door optimisme en hoge verwachtingen over het potentieel van AI om data-analyse en besluitvorming te revolutioneren, wat leidde tot aanzienlijke onderzoeks- en praktische toepassingen in belangrijke industrien.
Tegen het einde van de jaren 90 stopten helaas veel organisaties hun AI-programma's omdat de industrie zich richtte op het web en wegbewoog van de droom van AI. In die periode werd de term "AI" soms vermeden vanwege eerdere niet-ingeloste beloften, waar het vaak Almost Implemented werd genoemd. Uit deze ervaringen kwamen verschillende lessen uit die tijd naar voren:
1. Beperkingen in schaalbaarheid
Een belangrijke uitdaging was het beheren en opslaan van zeer grote datasets, specifiek met betrekking tot variëteit en snelheid van data. Databasebeheersystemen destijds voldeden niet adequaat aan deze behoeften, wat het belang benadrukte van robuuste en aanpasbare data-infrastructurenvooral relevant in sectoren zoals landbouw.
2. Te veel afhankelijkheid van open source tools
Vanwege een beperkt aantal commerciële oplossingen was er een sterke afhankelijkheid van intern ontwikkelde tools en open-source software, wat onderhouds- en beveiligingsproblemen veroorzaakte na personeelswisselingen.
3. Het belang van hoogwaardige trainingsdata
Het ontwikkelen van effectieve machine learning-modellen was afhankelijk van nauwkeurige, lokaal geïnformeerde trainingsdatasets. Er werden inspanningen geleverd om directe satellietdata wereldwijd te verzamelen om voorspellende prestaties te verbeteren, inclusief succesvolle toepassingen zoals verbeterde orkaanvoorspellingen.
Tegenwoordig hebben technologische vooruitgangen veel schaalbaarheids- en infrastructuurproblemen opgelost, en bieden talrijke gevestigde bedrijven betrouwbare AI-oplossingen. Echter blijft de voortdurende uitdaging beschikbaarheid en kwaliteit van trainingsdata, vooral in vakgebieden zoals landbouw waar vertrouwen en datakwaliteit uitdagend zijn. In een omgeving waar desinformatie uitkomsten kan beïnvloeden is het cruciaal om betrouwbare, accurate en relevante AI-systemen te behouden om voortdurende vooruitgang te waarborgen en toekomstige terugslagen te voorkomen.
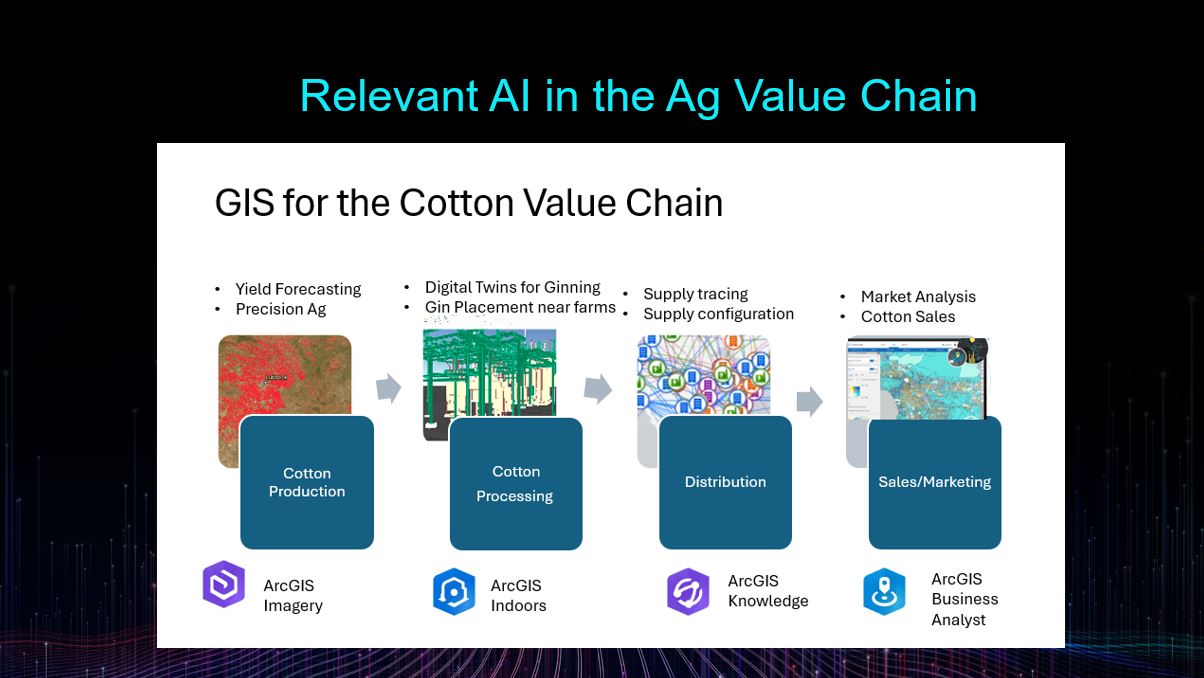
Het lange antwoord voor landbouw is om zich te richten op het zorgvuldig invoegen van AI in bestaande workflows binnen de Ag waardeketen.
Laten we katoen als voorbeeld nemen. Katoen genereert ongeveer $7.1 miljard aan Amerikaanse contante ontvangsten, waarvan een derde wordt geproduceerd in droogtegevoelig Texas, dat sterk afhankelijk is van irrigatie uit bronnen zoals het Ogallala-aquiferdat naar verwachting binnen 50 tot 100 jaar zal opdrogen. In 2022 lieten ongeveer 74% van boeren hun gewassen vallen en kozen ze voor verzekeringsuitkeringen. Veldopbrengsten beïnvloeden waar verwerkers gins plaatsen om transportkosten te verminderen, wat invloed heeft op de bredere toeleveringsketen en verkoop.
AI kan op veel gebieden worden toegepast in de katoenindustrie: Spatial Data Science helpt bij marktanalyse voor diverse cultivars; Knowledge Graphs helpen bij configuratie en balentraceerbaarheid in toeleveringsketens; Digital twins simuleren gin-operaties; en Large Language Models kunnen kennisgrafieken gebruiken over het katoenproces en algemene staat van productie.
Echter is investeren in AI voor opbrengstvoorspelling bijzonder waardevol omdat nauwkeurige voorspellingen cruciaal zijn voor de hele toeleveringsketen. Laten we dit verder onderzoeken.
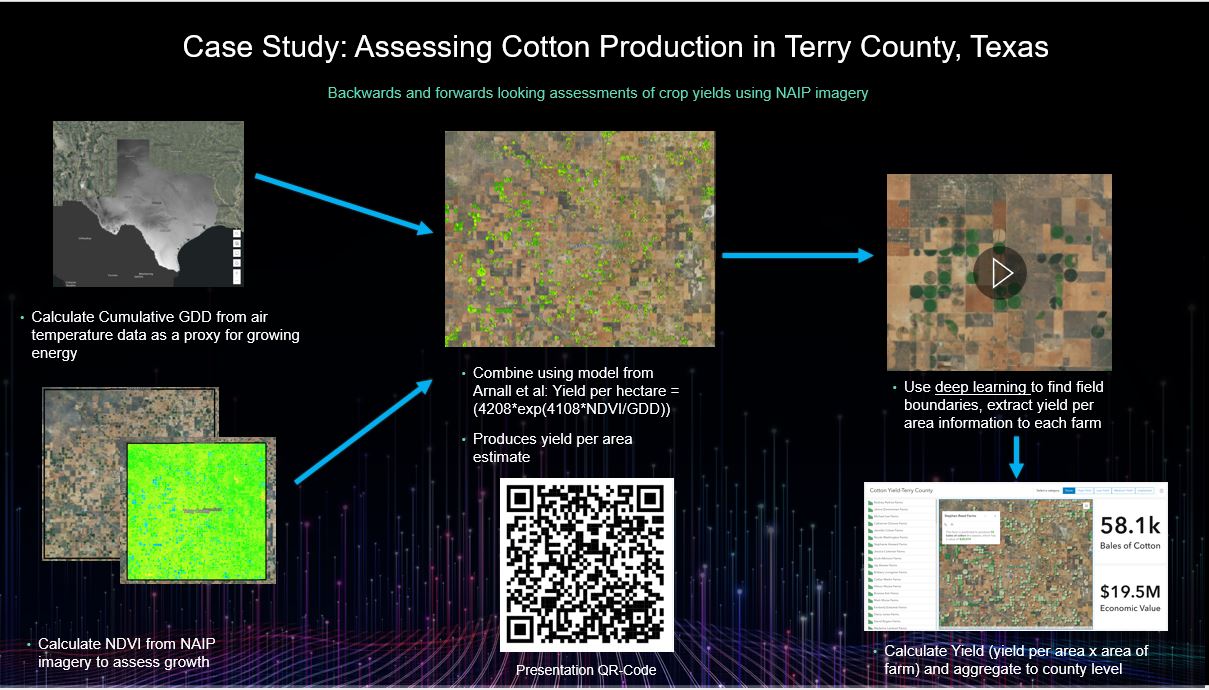
Hier is een eenvoudig voorbeeld van het schatten van katoenopbrengst in Noord-Texas door temperatuur- en vegetatiegegevens te combineren op basis van groeigraden (zie presentatie over Raster Analytics).<\/P>
Om de opbrengst op veldniveau te voorspellen voor geïnformeerde landbouwbeslissingen, moet het systeem veldlocaties herkennen. Deze taak maakt gebruik van deep learning, en Esri biedt voorgetrainde geospatiale modellen die integratie in workflows vereenvoudigen. Met voorspellende prognoses kunnen boeren onderpresterende gebieden identificeren en overwegen om conserverings- of andere landbouwbeheerpraktijken toe te passen om de resultaten te verbeteren.<\/P>
Hoewel begeleiding van experts deze aanpak ondersteunt, vereist het valideren van resultaten gestructureerde lokale input van boeren op veldniveau—gegevens op county-niveau van USDA alleen zijn niet voldoende. Lokale kennis is cruciaal voor het bouwen van geavanceerde trainingssets die verder gaan dan wat voorgetrainde modellen bieden.<\/P>
Daarom is samenwerking met bedrijven zoals Land O’ Lakes en AC Foods, en de Ag GIS-gemeenschap essentieel—zij hebben de vertrouwde relaties die nodig zijn om deze modellen te verifiëren. Esri levert de tools, maar het uitbreiden van AI-oplossingen hangt af van de gegevens en expertise van partners in samenwerking met extensiediensten (bijv. Texas A&M AgriLife Extension Service).<\/P>
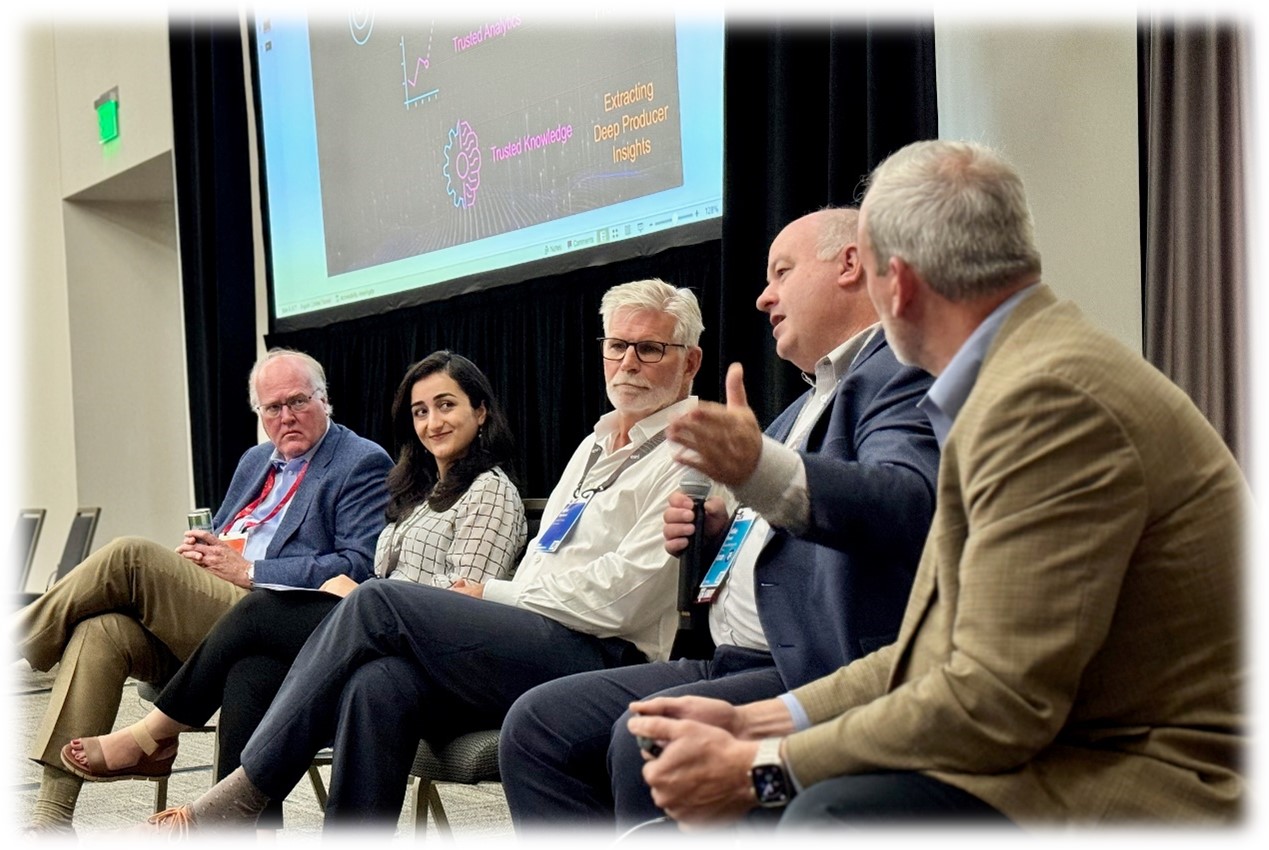
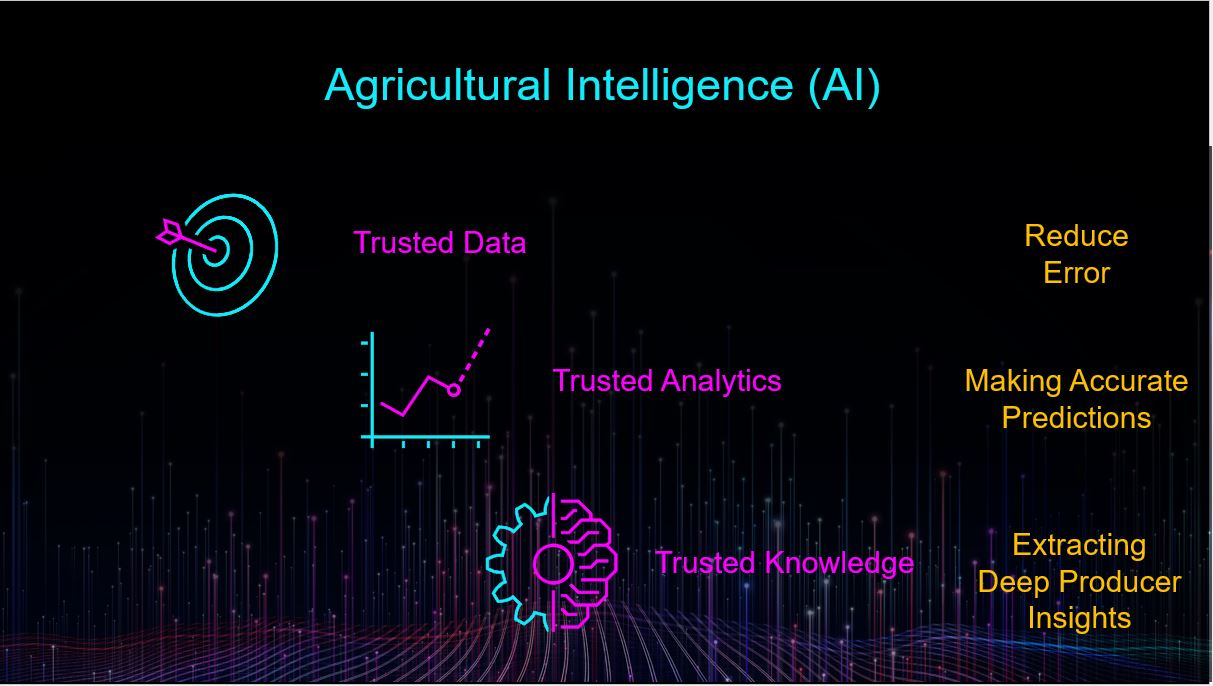 <\/span><\/P> Samenvattend is de landbouw een voorzichtig vakgebied waar fouten aanzienlijke verliezen kunnen veroorzaken. Onze rol is ervoor te zorgen dat AI volledig wordt geïmplementeerd, met betrouwbare, vertrouwde gegevensbeheer- en analysetools, terwijl lokale landbouwkundige expertise wordt betrokken om vertrouwde kennis te behouden. Deze aanpak zal ervoor zorgen dat AI echt betekent Agricultural Intelligence<\/STRONG>.<\/P>De Paneldiscussie<\/U><\/STRONG><\/FONT><\/P>Om de rol van Agricultural Intelligence te bespreken, heeft de Ag SIG vertegenwoordigers uit zowel de industrie als de academische wereld, waarbij panelleden waren (zoals hieronder afgebeeld, van links naar rechts):<\/P>Nick Short<\/STRONG>, Ag Industry Solutions Manager, Esri<\/LI>Sanaz Havaei<\/STRONG>, Business Application Analyst, AC Foods<\/LI>Kirk Wythers<\/STRONG>, Business Value Lead, Land O’ Lakes<\/LI>Mike Buser<\/STRONG>, Professor, Endowed Chair in Cotton Engineering, Ginning, and Mechanization, Texas A&M AgriLife<\/LI>Mark Dann<\/STRONG>, Sr. Account Manager, Esri<\/LI><\/UL>Het panel besprak de volgende vragen:<\/P>Welke kansen ziet u om ML te benutten voor Predictive Yield Forecasting, en welke impact zou dit op het bedrijf kunnen hebben?<\/EM><\/P>“Wat zijn enkele manieren waarop u AI - Advanced Geospatial Analytics gebruikt in uw verschillende bedrijven en R&D-toepassingen?” <\/EM><\/P>De algemene consensus binnen de groep was dat vertrouwde AI, net als Data Science, afhankelijk is van een solide gegevensbeheerinfrastructuur om ervoor te zorgen dat de algoritmen worden gevoed met kwaliteitsgegevens.<\/P>
 <\/span><\/P>
