Lire les sujets d'aide...
1 Featureclass vers tableau NumPya0
FeatureClassToNumPyArray peut être utilisé pour extraire les sommets des entités géométriques. S'ils sont monopartis sans trous, alors vous avez une représentation exacte qui peut être utilisée pour recréer les entrées. Si ce n'est pas le cas, la reconstruction demande un certain travail (voir https://github.com/Dan-Patterson/numpy_geometry pour le module `npg`).
2 Tableau NumPy vers Featureclassa0
NumPyArrayToFeatureClass ne remplacera pas une classe d'entités existante, même si l'environnement overwriteOutput est défini sur True.
------------------------------
Étape par étape... un notebook est joint
# ---- Importations
import arcpy
import numpy as np
from numpy.lib.recfunctions import structured_to_unstructured as stu
from numpy.lib.recfunctions import append_fields  # comme arcpy ExtendTable
Je suppose que vous utilisez un notebook dans ArcGIS Pro. Je vais démontrer une conversion simple de polygones en tous points. Les autres options peuvent aussi être codées, ou simplement acheter un niveau de licence Pro supérieur.
a0
Supposons que votre couche soit dans une carte. Spécifiez le nom de la couche et si vous souhaitez conserver des champs supplémentaires de la table.
# Spécifiez la couche à utiliser pour la variable `lyr_name`
# Cela ne fonctionne que pour les featureclasses... pas de vérification d'erreur supplémentaire... la pression est là
#
lyr_name = 'sq3'  # -- saisissez le nom de la featureclass
extra_fields = True  # -- True conserve tous les champs supplémentaires, False sinon... juste certains ? écrivez le vôtre
a0
Maintenant la grande étape.
- vérifiez que la couche existe dans la carte active. Si oui, continuez, sinon abandonnez.
- la source de données de la couche et la référence spatiale sont obtenues,
- une liste de champs à exclure de la sortie (lignes 11-15)
- un tableau est créé (lignes 16-21). C'est un tableau numpy produit par la fonction arcpy.da conçue à cet effet.
- un peu de nettoyage suit, les champs de sortie sont spécifiés et ajoutés à la sortie (le cas échéant)
- la featureclass de sortie est créée (ligne 36)
- et ajoutée à la carte (ligne 37)
# ---- Projet, carte et collection de couches
#  Le projet actuel avec la carte active est vérifié pour le nom de couche que vous avez spécifié ci-dessus.
#  S'il existe, les sommets seront convertis en une featureclass ponctuelle.
#
aprx = arcpy.mp.ArcGISProject("CURRENT")
map_ = aprx.activeMap
lyrs = map_.listLayers(lyr_name)
if lyrs:
    in_fc = lyrs[0].dataSource  # -- chemin vers la featureclass
    SR = arcpy.Describe(in_fc).spatialReference
    ignore_flds = ['OBJECTID', 'Shape', 'Shape_Area', 'Shape_Length']  # -- ajoutez si vous voulez
    keep_flds = ["OID@", "SHAPE@X", "SHAPE@Y"]
    if extra_fields:
        add_flds = [f.name for f in arcpy.ListFields(in_fc) if f.name not in ignore_flds]
        keep_flds = keep_flds + add_flds
    arr = arcpy.da.FeatureClassToNumPyArray(
        in_fc,
        field_names=keep_flds,
        spatial_reference=SR,
        explode_to_points=True
    )
    # -- vérifications de la featureclass de sortie
    out_fc = in_fc + "_pnts"
    if arcpy.Exists(out_fc):  # -- supprimez si elle existe
        arcpy.management.Delete(out_fc)
    #
    # -- vérifications du tableau et combinaison des valeurs coordonnées
    dt_ = arr.dtype
    dt_names = [(i[0].replace("@", "_"), i[1]) for i in arr.dtype.descr]
    arr.dtype = dt_names
    #
    final_arr = append_fields(arr, ["Pnt_x", "Pnt_y"], [arr["SHAPE_X"], arr["SHAPE_Y"]])
    print("\nChamps de sortie :\n{}".format(final_arr.dtype.names))
    #
    # -- produire la sortie et ajouter à la carte.
    arcpy.da.NumPyArrayToFeatureClass(final_arr, out_fc, ["SHAPE_X", "SHAPE_Y"], spatial_reference=SR)
    map_.addDataFromPath(out_fc)  # -- ajouter les résultats à la carte
    #
else:
    print("Aucune couche appelée {}".format(lyr_name))
Et les résultats sont
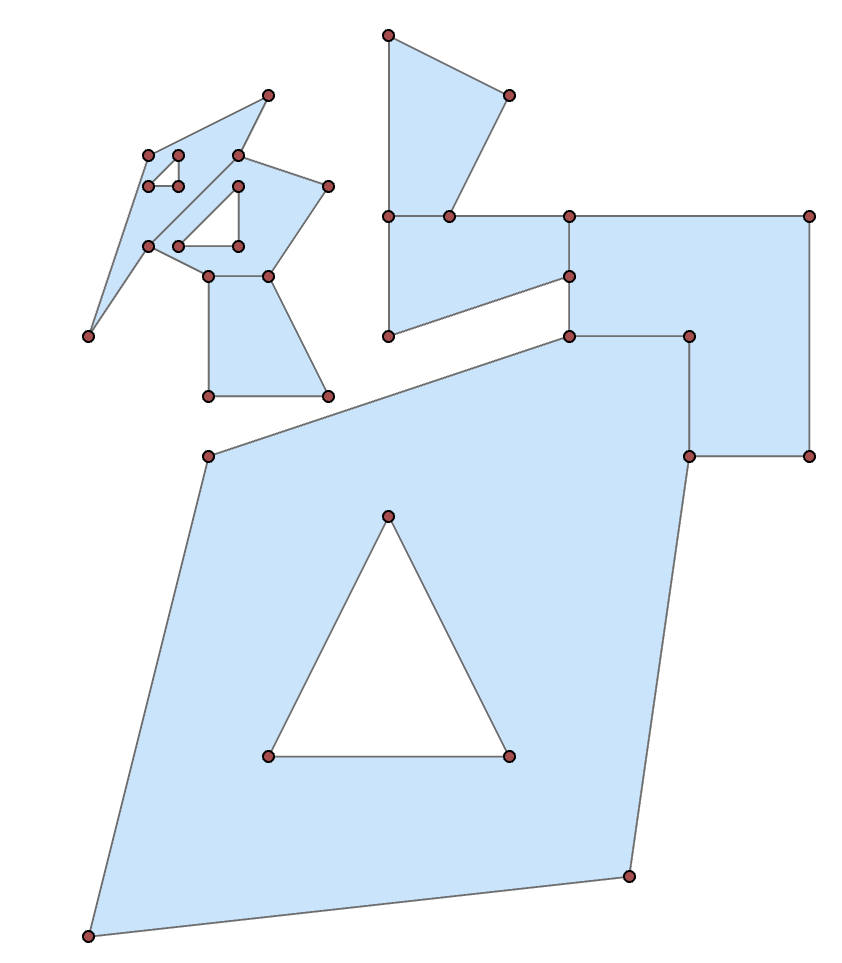
Je vous épargne le contenu du tableau, mais ils sont là.
--------------
Si vous préférez la fenêtre python
import arcpy
import numpy as np
in_fc = r"C:\...chemin vers votre couche...\...nom_de_couche..."
keep_flds = ["OID@", "SHAPE@X", "SHAPE@Y"]
SR = arcpy.Describe(in_fc).spatialReference
arr = arcpy.da.FeatureClassToNumPyArray(
        in_fc,
        field_names=keep_flds,
        spatial_reference=SR,
        explode_to_points=True
    )
'Ce qui montre le format des données du tableau structuré. (extrait pour simplifier)'
arr
array([(1, 300009. , 5000001. ), (1, 300000. , 5000000. ),
       (1, 300002. , 5000008. ), (1, 300008. , 5000010. ),
 ... extrait
       (7, 300004. , 5000009. ), (7, 300002. , 5000009. ),
       (7, 300002. , 5000011. )],
      dtype=[('OID@', '<i4'), ('SHAPE@X', '<f8'), ('SHAPE@Y', '<f8')])
Vous pouvez ensuite diviser le tableau en ses formes constituantes en utilisant le champ OID@. Déterminez essentiellement la différence dans les valeurs d'identifiant séquentiel, où elles diffèrent de 0, obtenez l'indice positionnel à utiliser pour diviser.
spl = np.nonzero(np.diff(arr["OID@"]))[0] + 1
À partir de là, vous pouvez produire des sous-tableaux
subs = np.array_split(arr, spl)

subs[0]  # -- le premier comme exemple
array([(1,  300009.000,  5000001.000), (1,  300000.000,  5000000.000),
       (1,  300002.000,  5000008.000), (1,  300008.000,  5000010.000),
       (1,  300010.000,  5000010.000), (1,  300010.000,  5000008.000),
       (1,  300009.000,  5000001.000), (1,  300003.000,  5000003.000),
       (1,  300007.000,  5000003.000), (1,  300005.000,  5000007.000),
       (1,  300003.000,  5000003.000)],
      dtype=[('OID@', '<i4'), ('SHAPE@X', '<f8'), ('SHAPE@Y', '<f8')])
From there you could process to just take the first or last point (one of the main tool options that requires and advanced licence).
frst = [i[0] for i in subs]  # let's grab the first point of each shape
frst

[(1,  300009.000,  5000001.000),
 (2,  300010.000,  5000008.000),
 (3,  300008.000,  5000011.000),
 (4,  300006.000,  5000012.000),
 (5,  300002.500,  5000013.000),
 (6,  300004.000,  5000012.500),
 (7,  300002.000,  5000011.000)]
As a teaser, you can even place a point at a certain percentage along the polygon perimeter with a little numpy magic
from numpy.lib.recfunctions import structured_to_unstructured as stu
base = [stu(a[["SHAPE@X", "SHAPE@Y"]]) for a in subs]
halfway = [_percent_along_(a, percent=50) for a in base]

halfway
[array([ 300010.000,  5000009.950]),
 array([ 300008.500,  5000012.000]),
 array([ 300005.000,  5000010.310]),
 array([ 300005.056,  5000014.972]),
 array([ 300000.214,  5000010.643]),
 array([ 300002.527,  5000012.991]),
 array([ 300003.894,  5000009.000])]
and the function for placing the points
def _percent_along_(a, percent=0):
    """Add a point along a poly feature at a distance from the start point."""
    # a = _base_(a)
    if percent > 1.:
        percent /= 100.
    dxdy = a[1:, :] - a[:-1, :]                        # coordinate differences
    leng = np.sqrt(np.einsum('ij,ij->i', dxdy, dxdy))  # segment lengths
    cumleng = np.concatenate(([0], np.cumsum(leng)))
    perleng = cumleng / cumleng[-1]
    if percent <= 0:              # check for faulty distance or start point
        return a[0]
    if percent >= perleng[-1]:    # check for greater distance than cumulative
        return a[-1]
    _end_ = np.digitize(percent, perleng)
    x1, y1 = a[_end_]
    _start_ = _end_ - 1
    x0, y0 = a[_start_]
    t = percent - perleng[_start_]
    xt = x0 * (1. - t) + (x1 * t)
    yt = y0 * (1. - t) + (y1 * t)
    return np.array([xt, yt])
Or you can 'arcpy' it if you prefer to crank up Pro.
So, basic functionality shouldn't be completely removed by license levels. If you have the need convert features to points, remember that tools are available within.