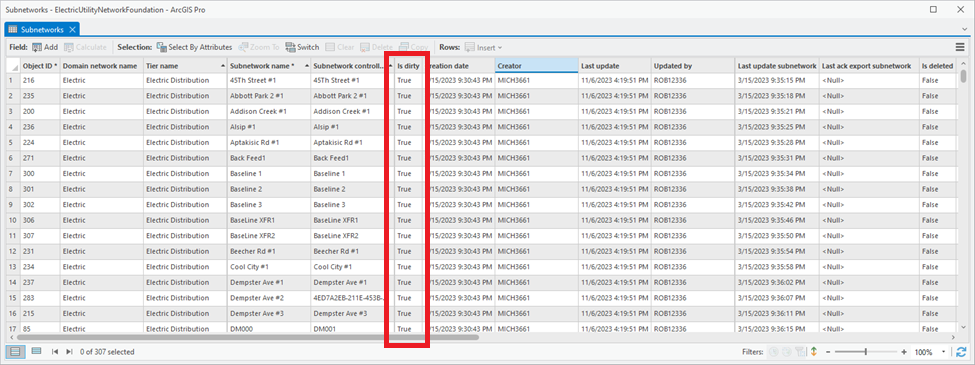
Lorsque le réseau de services publics a été lancé pour la première fois, il a introduit un nouveau concept dans l'écosystème et le vocabulaire Esri, le Sous-réseau. Cette abstraction a été créée pour décrire les différentes manières dont les utilisateurs séparent et gèrent leurs réseaux en zones réseau sans utiliser de termes spécifiques à l'industrie comme « Circuit » ou « Zone de pression ».
Mais pourquoi utilisons-nous le terme « sous-réseau » ?
Toutes les données utilisées pour gérer la connectivité d'un ensemble de ressources pour un service public sont stockées dans un réseau de services publics (par exemple, le réseau). Ainsi, lorsque ce réseau est subdivisé en zones plus petites, topologiquement contiguës (circuits, zones de pression, etc.), chacune de ces zones peut être décrite avec précision comme un sous-réseau. Avec cette abstraction en place, un cadre a été créé pour gérer chaque sous-réseau comme son propre objet SIG pouvant être visualisé, analysé et même utilisé à des fins de rapport. Un composant important de ce cadre est la capacité à suivre les métadonnées sur chaque sous-réseau afin que les utilisateurs puissent comprendre comment leur système évolue dans le temps.
Ces métadonnées fournissent des informations de base telles que les champs de suivi des éditeurs ou peuvent être étendues pour incorporer des valeurs définies par l'utilisateur telles que le nombre de clients, le nombre de dispositifs de protection, etc. Les métadonnées permettent également aux utilisateurs de répondre à la question la plus courante et importante qu'une personne SIG reçoit : ces données sont-elles correctes ?
C'est une question étonnamment difficile car « correct » signifie différentes choses pour différentes personnes. Cependant, en décomposant la question originale en questions plus spécifiques, il devient beaucoup plus facile d'y répondre :
- Quand le sous-réseau a-t-il été mis à jour pour la dernière fois ?
- Quand le sous-réseau a-t-il été extrait pour la dernière fois vers un autre système ?
- Ce sous-réseau est-il à jour ?
- Les entités du sous-réseau ont-elles été modifiées depuis sa dernière mise à jour ?
- Y a-t-il des erreurs connues qui doivent être corrigées dans ce sous-réseau ?
Les deux premières questions sont faciles à répondre grâce à plusieurs champs de date maintenus sur le sous-réseau, notamment les champs Dernière mise à jour du sous-réseau et Dernière exportation Ack du sous-réseau. Les trois dernières questions peuvent toutes être répondues en regardant le champ Statut d'un sous-réseau (dans les modèles antérieurs, cela s'appelait le champ « Est sale ») qui inclut les valeurs de statut Propre, Sale et Invalide. Voici ce que signifient ces valeurs :
- Propre – Un sous-réseau qui n'a pas d'erreurs connues et est prêt à être utilisé pour l'analyse.
- Sale – Un sous-réseau qui a été modifié et qui doit être mis à jour.
- Invalide – Un sous-réseau qui présente une ou plusieurs erreurs connues devant être résolues.
Une fois les bases établies, le reste de cet article se concentrera sur la manière dont le système gère le champ Statut et comment interpréter chacune des différentes valeurs de statut.
Marquer les Sous-réseaux comme Sales
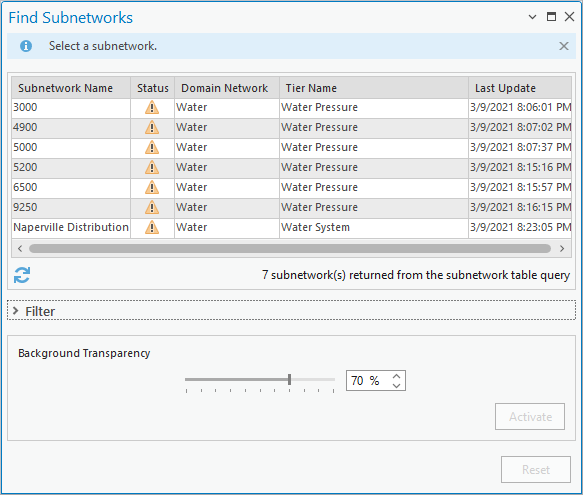
La clé pour gérer le statut des sous-réseaux dans le réseau de services publics est que le système doit pouvoir déterminer quand un sous-réseau est affecté par une modification afin qu'il puisse être marqué comme sale. Bien qu'il existe plusieurs façons d'y parvenir, le logiciel utilise actuellement l'opération valider la topologie du réseau pour découvrir et marquer les sous-réseaux comme sales. Parce que déterminer quel sous-réseau a été affecté par une modification nécessite un traçage, cela introduirait trop de surcharge dans le processus d'édition si le système effectuait cette analyse après chaque modification. Enfin, parce que tous les flux de travail d'édition affectant le réseau doivent être validés, cela permet au système de garantir que l'état des sous-réseaux ne peut pas se désynchroniser avec les données au fur et à mesure qu'elles sont modifiées.
Mais comment le système détermine-t-il quels sous-réseaux ont été modifiés ?
Le système effectue une trace du contrôleur de sous-réseau pour toutes les entités validées afin de découvrir quels sous-réseaux ont été affectés par les modifications. Le comportement exact diffère légèrement selon que les modifications validées appartiennent à un réseau partitionné ou hiérarchique de services publics. Que signifient ces termes et pourquoi cela importe-t-il ? Nous en discuterons ci-dessous.
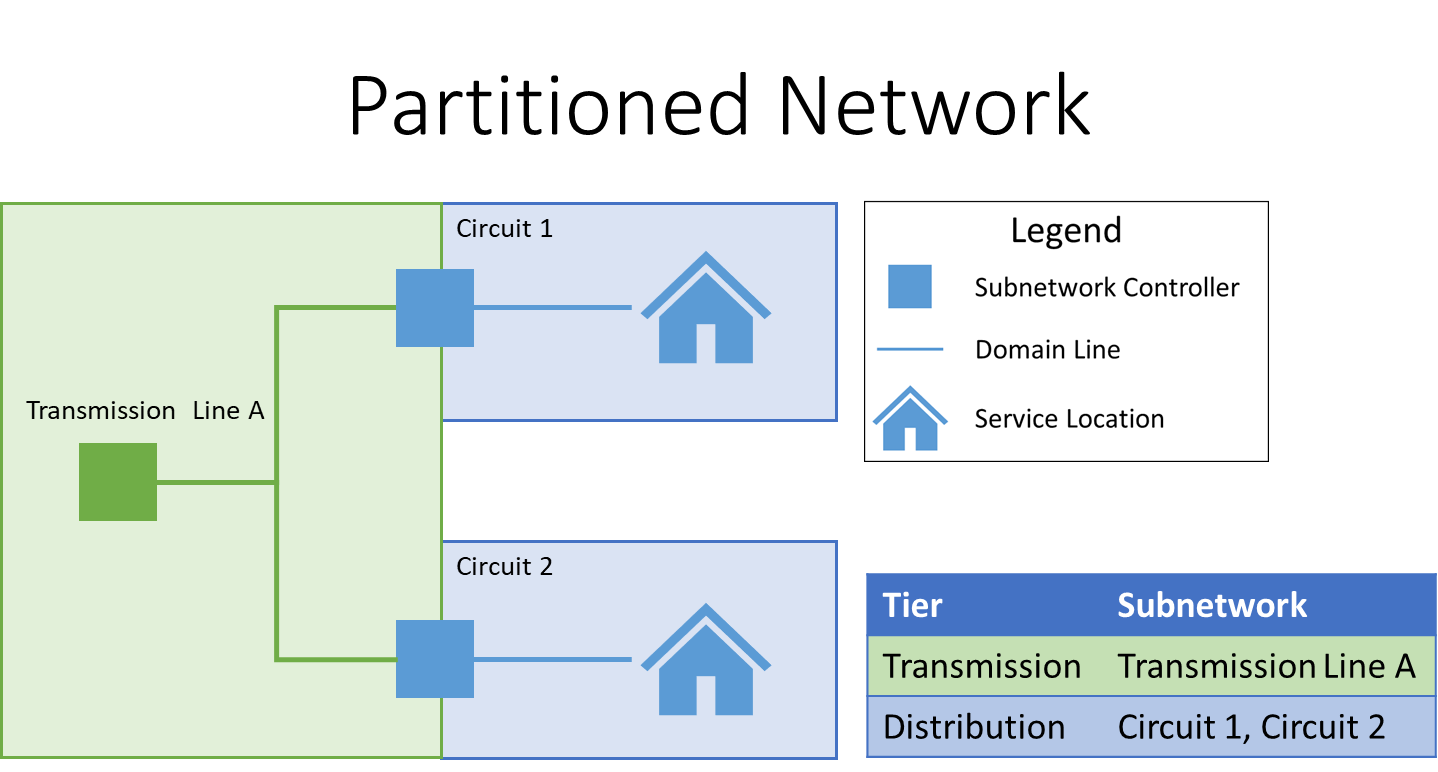
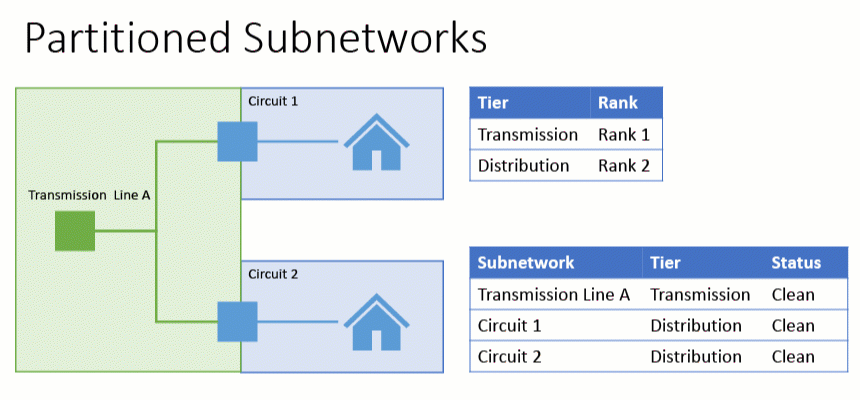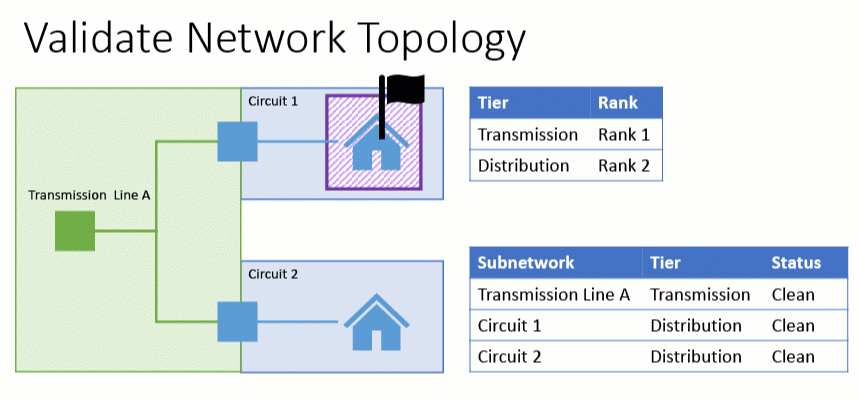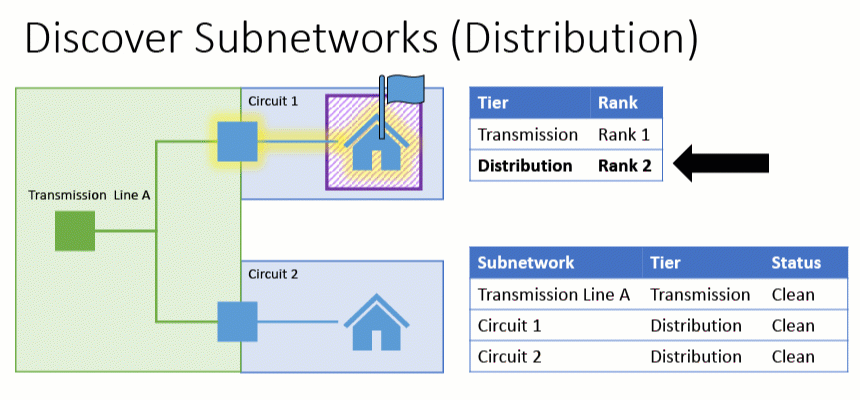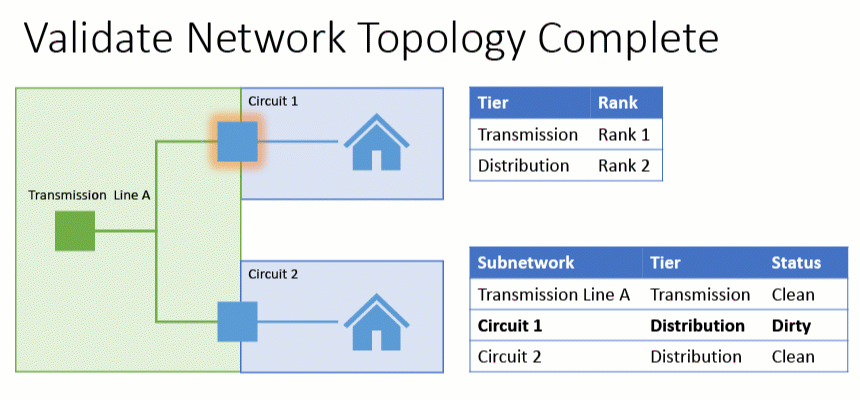
Dans un sous-réseau partitionné, chaque entité peut appartenir au maximum à un seul sous-réseau. Cela signifie que le système analysera chaque niveau du réseau pour déterminer si l'une des entités modifiées appartient à ce niveau. Une fois qu'une entité a été associée à un sous-réseau spécifique, elle peut être retirée de l'analyse dans les niveaux suivants, et une fois que toutes les entités ont été associées, l'analyse est terminée, même si tous les niveaux n'ont pas été analysés. Vous pouvez voir un exemple simplifié d'un réseau partitionné ci-dessous :
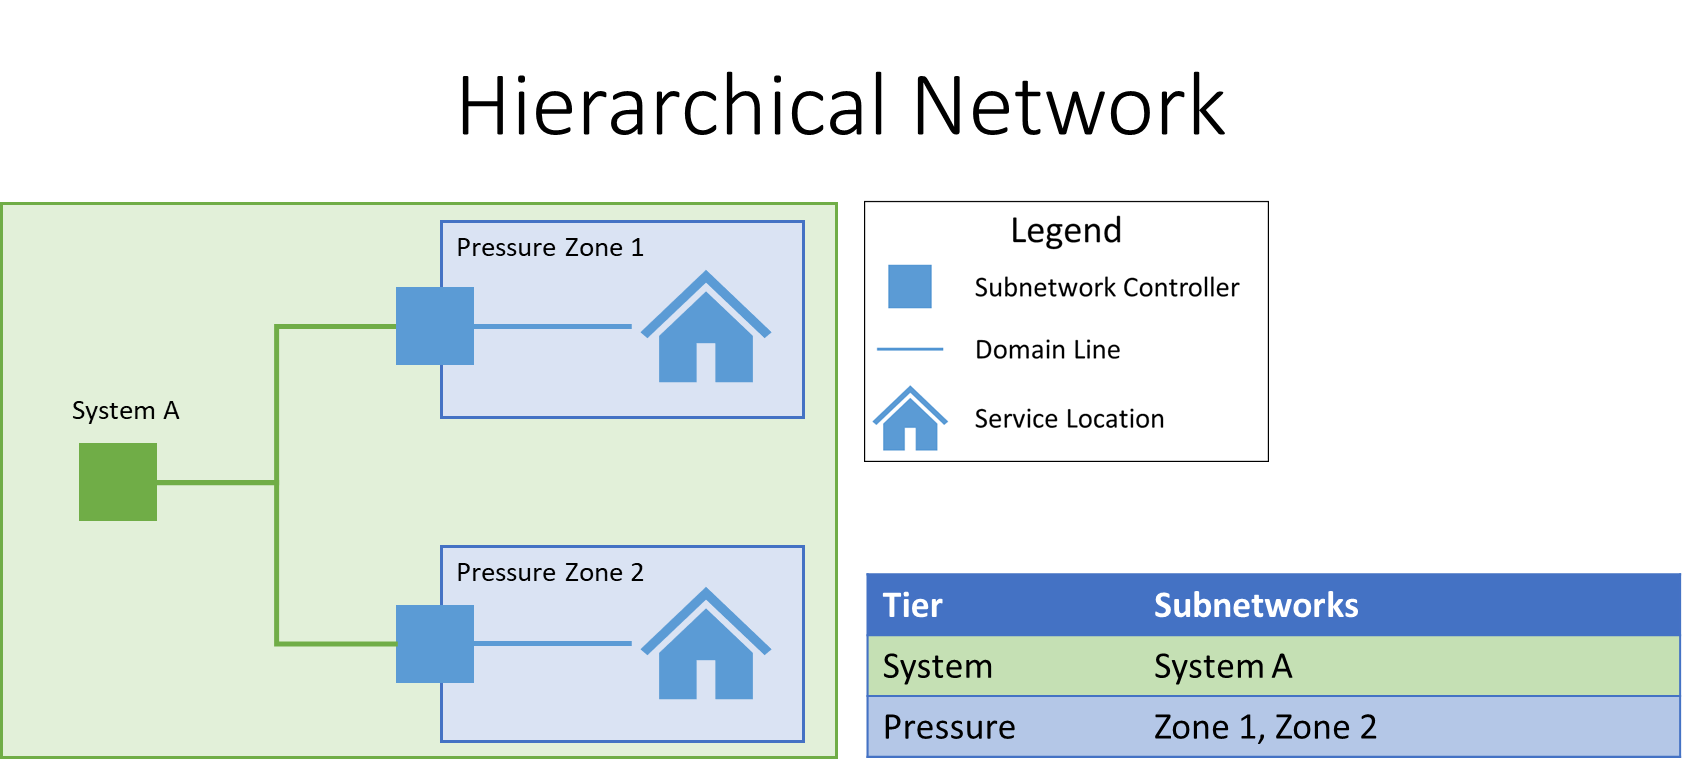
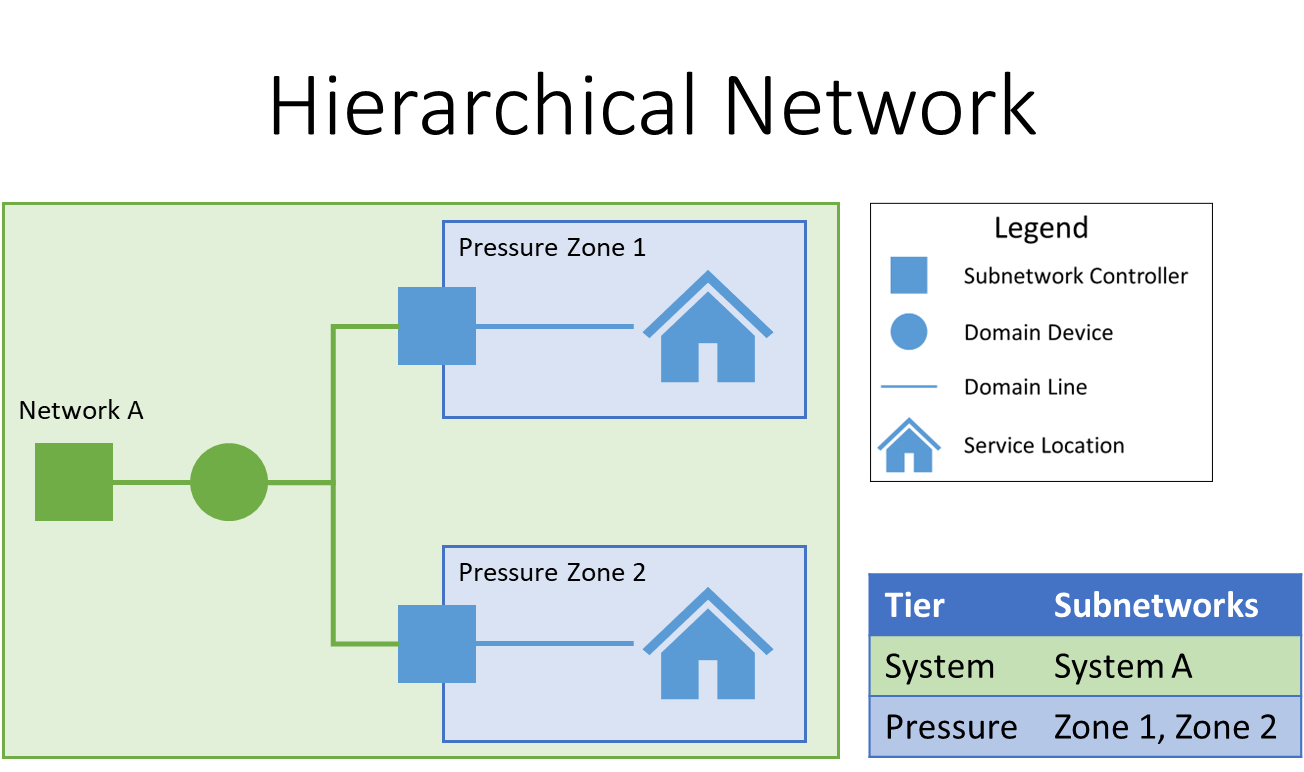
Dans le cas d'un réseau hiérarchique, chaque entité peut appartenir à plusieurs sous-réseaux car les niveaux du réseau sont imbriqués les uns dans les autres. En conséquence, le système doit toujours analyser chaque niveau du réseau pour toutes les entités modifiées. Vous pouvez voir un exemple simplifié d'un réseau hiérarchique ci-dessous :
Maintenant que nous avons examiné les différents types de topologie à un niveau élevé, nous allons examiner plusieurs scénarios d'édition pour chacun de ces types de topologie et noter comment le système se comporte.
Partitionné
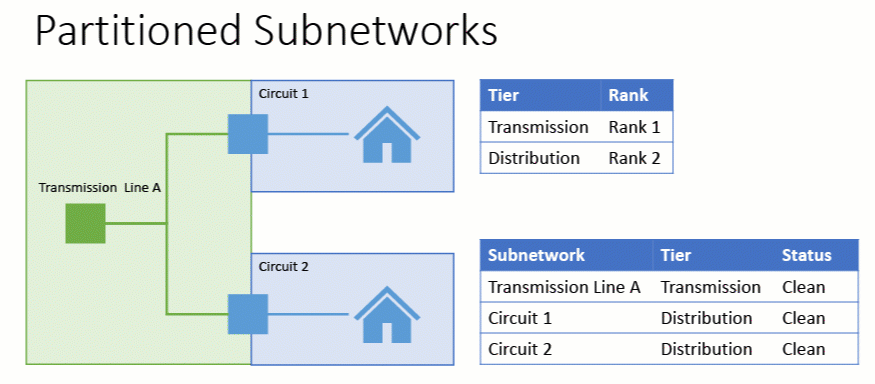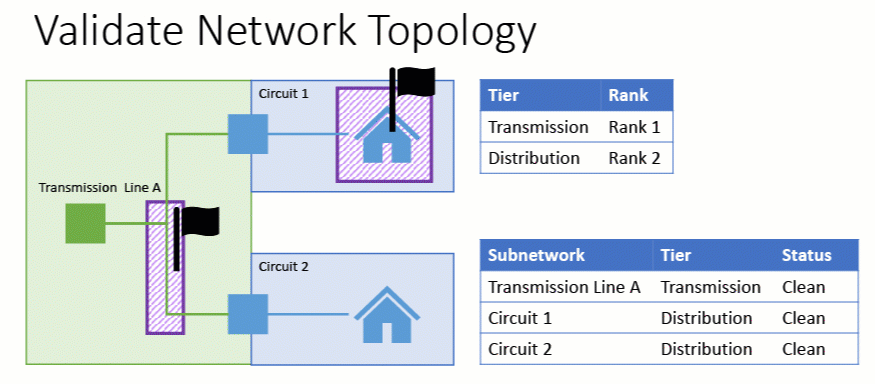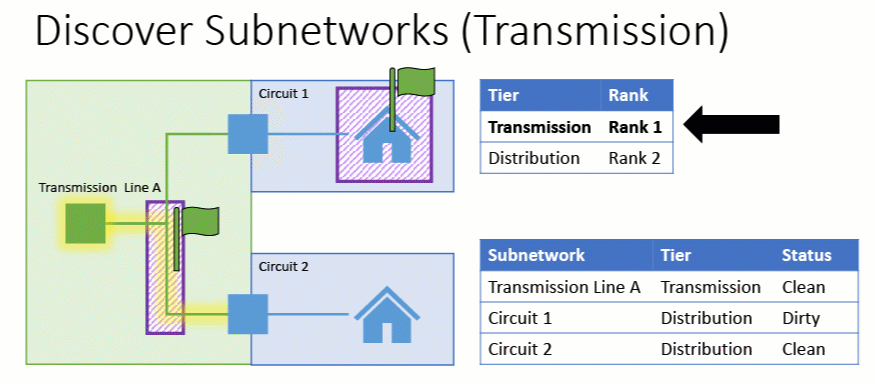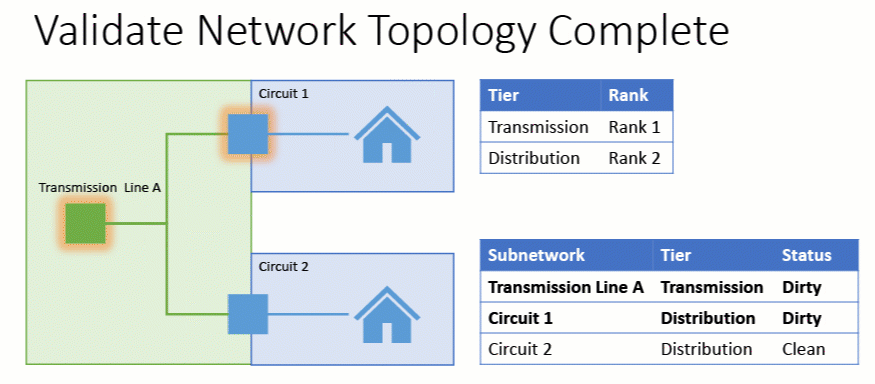
Lorsque la topologie du réseau est validée dans un réseau partitionné, le système doit identifier le sous-réseau affecté par chaque modification. Pour ce faire, il identifie tous les niveaux du réseau qui ont des sous-réseaux et analyse chaque niveau pour déterminer quels sous-réseaux dans chaque niveau, s'il y en a, ont été affectés par la modification. Le système répète ce processus avec chaque niveau jusqu'à ce qu'il ait découvert des sources réseau pour toutes les entités modifiées ou que tous les niveaux du réseau aient été analysés. Examinons quelques exemples de ce comportement en action.
Dans le premier exemple ci-dessous, une seule modification est apportée au réseau de services publics (polygone hachuré violet). Lorsque la validation de la topologie du réseau s'exécute, elle trouve une seule source réseau pour la modification sur le premier niveau analysé, celui de la distribution. Cela permet à la validation d'éviter toute analyse sur le niveau transmission puisque le système a déjà découvert un contrôleur de sous-réseau qui couvre toutes les modifications.
Dans ce deuxième exemple, plusieurs modifications dans plusieurs zones différentes du réseau sont validées. Le système doit effectuer plusieurs traces pour découvrir des sources pour toutes les modifications car celles-ci ont eu lieu dans plusieurs niveaux du réseau.
Dans le troisième exemple, le système valide une modification apportée à une entité qui n'est connectée à aucun sous-réseau. Dans ce cas, le système doit tracer tous les niveaux du réseau pour confirmer qu'aucun sous-réseau n'a été affecté.
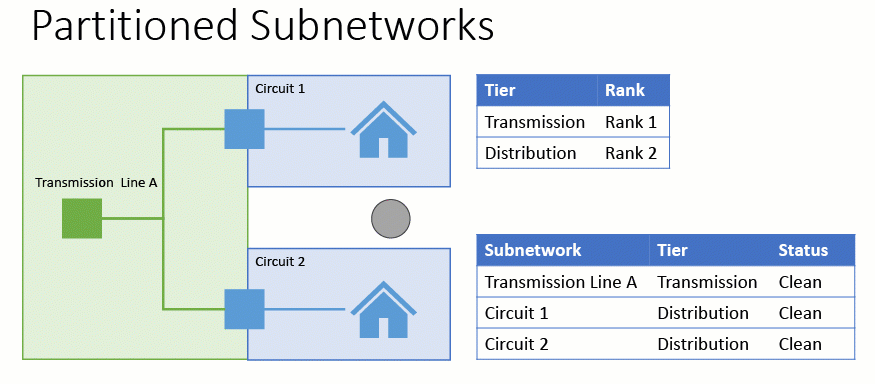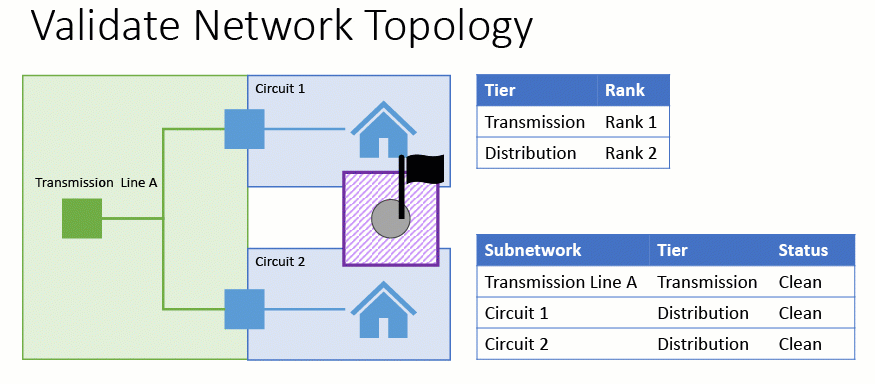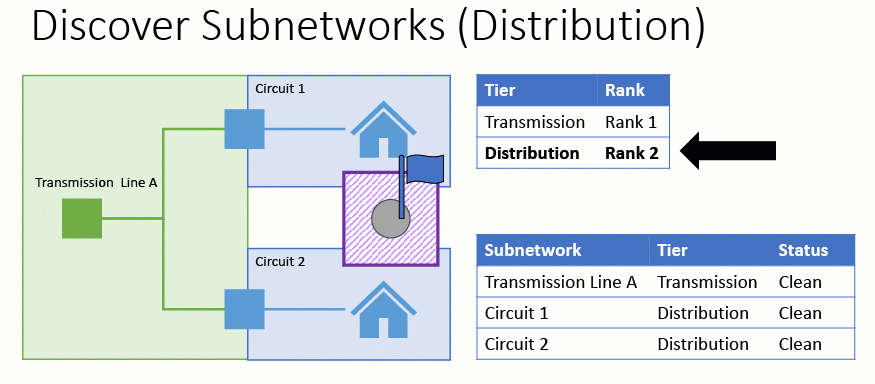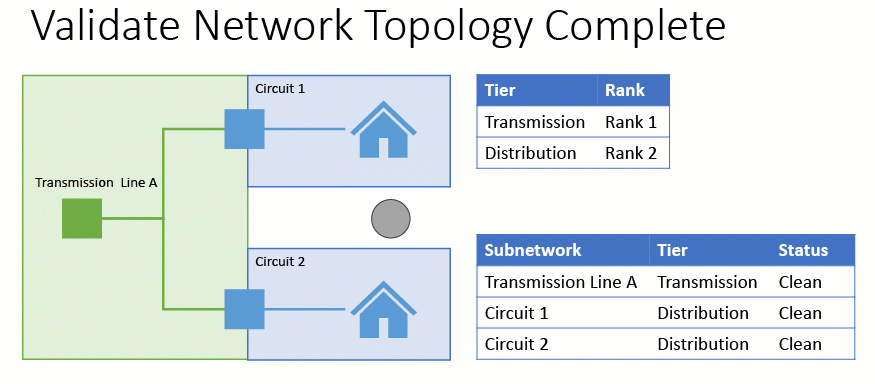
Comme vous pouvez le voir, l'opération valider la topologie du réseau peut identifier plus rapidement les sous-réseaux modifiés dans les réseaux partitionnés lorsque les modifications sont limitées à un seul niveau et lorsque les sous-réseaux modifiés sont plus petits. À mesure que le nombre de niveaux et la taille du sous-réseau augmentent, il faudra plus de temps au système pour identifier les sous-réseaux modifiés lors de la validation car il doit effectuer plus de traces et celles-ci prendront plus longtemps.
Hiérarchique
Parce que chaque entité dans un réseau hiérarchique peut appartenir à plusieurs niveaux, le système doit considérer chaque niveau du réseau ayant des sous-réseaux lorsqu'il tente d'identifier ceux affectés lors de la validation de la topologie du réseau.
Vous pouvez voir ci-dessous un exemple simple d'un réseau hiérarchique qui possède un seul sous-réseau système contenant deux plus petits sous-réseaux.
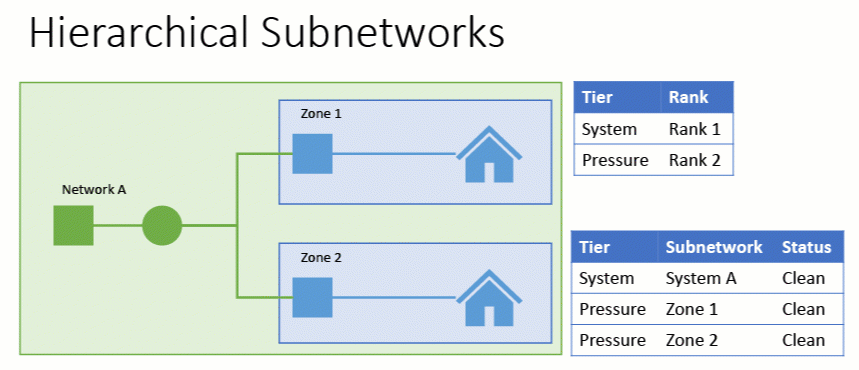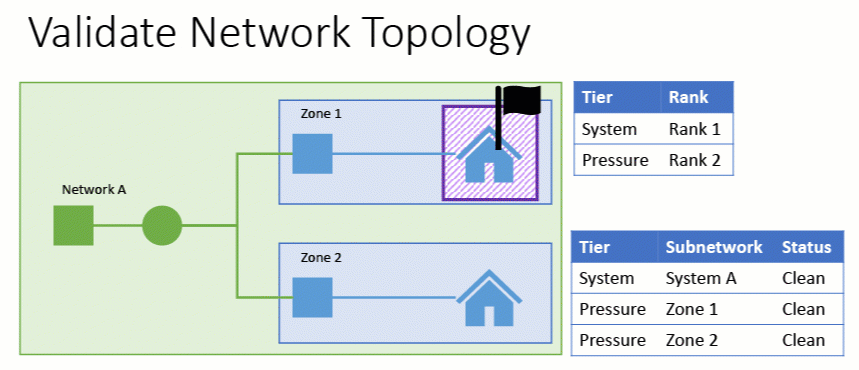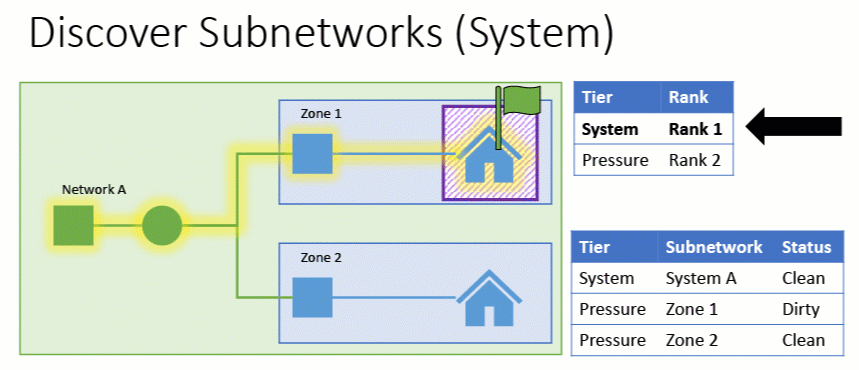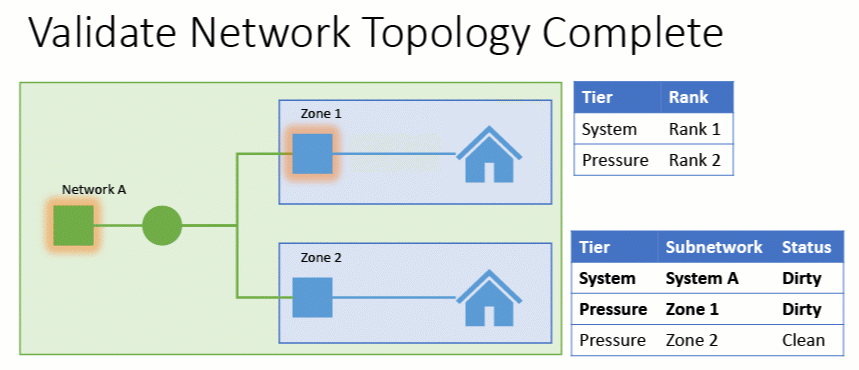
Dans ce premier exemple ci-dessous, une entité appartenant à l'un des plus petits sous-réseaux est modifiée. Le système identifie d'abord le plus petit sous-réseau auquel appartient la modification. Cependant, parce qu'il s'agit d'un sous-réseau hiérarchique, le système doit analyser tous les autres niveaux du réseau et dans ce cas il identifie un second sous-réseau dans un autre niveau à marquer comme sale.
Dans le deuxième exemple, une entité appartenant exclusivement au plus grand sous-réseau est modifiée. Dans ce cas, les sous-réseaux inférieurs ne sont pas marqués comme sales car la modification n'a pas affecté ces derniers. Cette logique est la même que le réseau soit basé sur la source ou sur l'évier car le réseau ayant la priorité la plus élevée est toujours l'enveloppe extérieure dans la hiérarchie (la source ultime ou l'évier ultime du réseau).
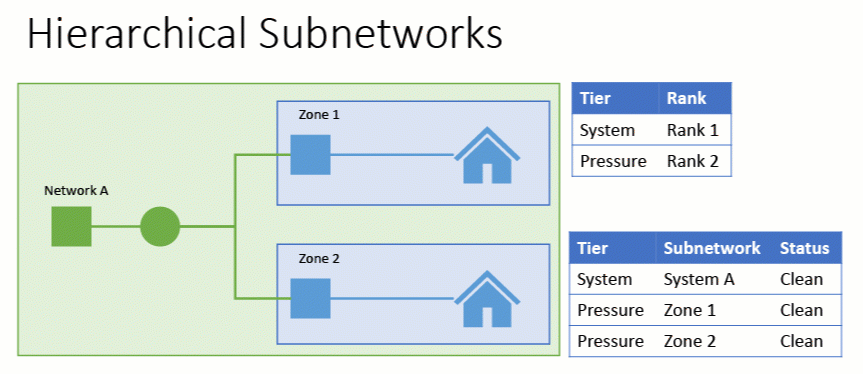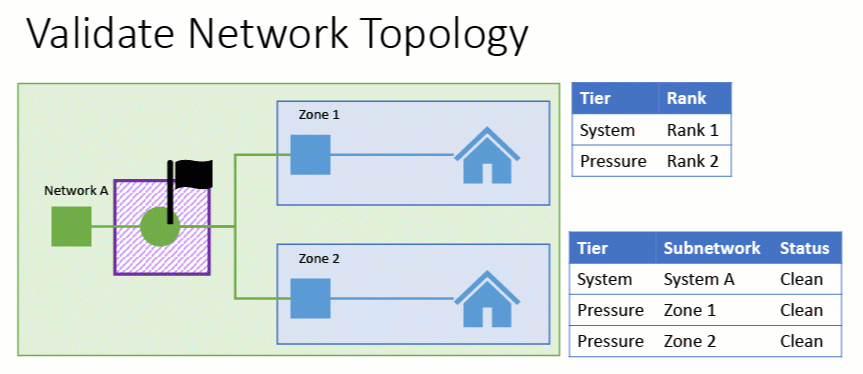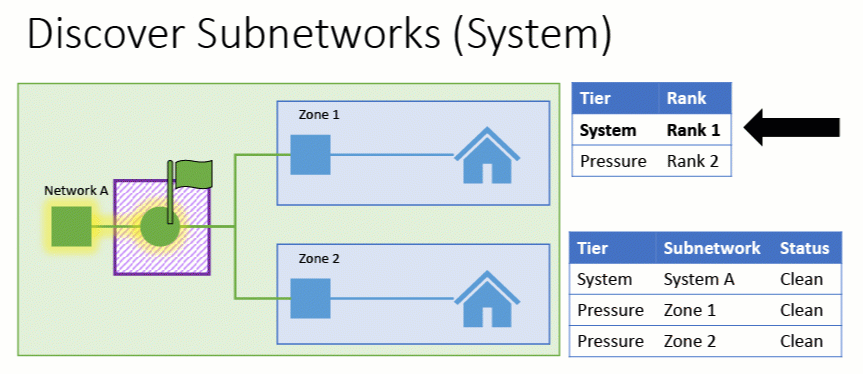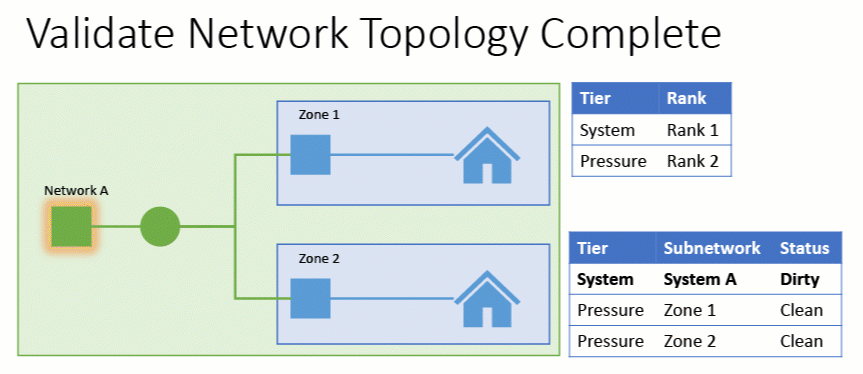
Dans le troisième exemple, une entité qui n'appartient pas à un sous-réseau est modifiée. Dans ce cas aucun sous-réseau n'est marqué comme sale. Cependant, le réseau doit tracer chaque niveau du réseau pour confirmer que l'entité n'appartient à aucun sous-réseau.
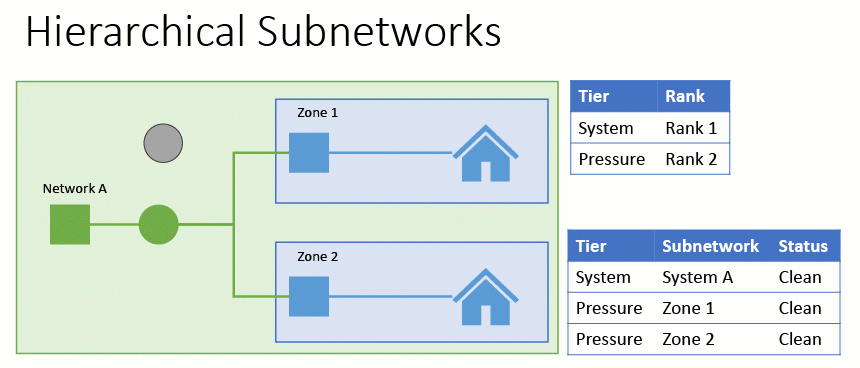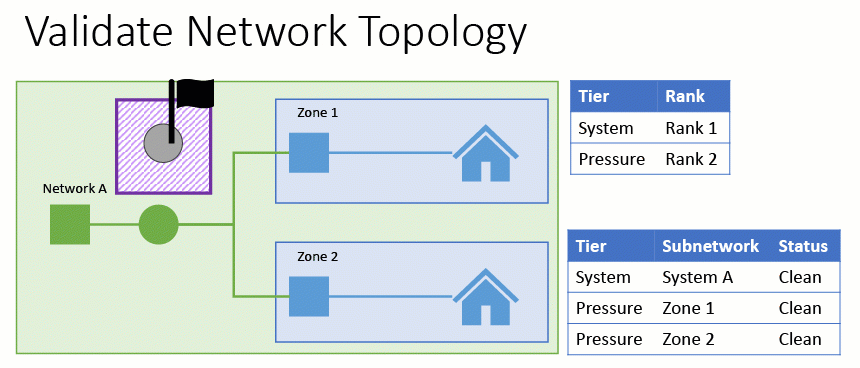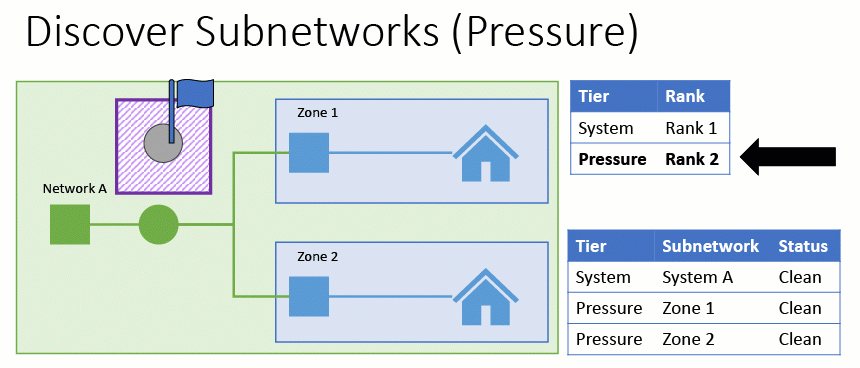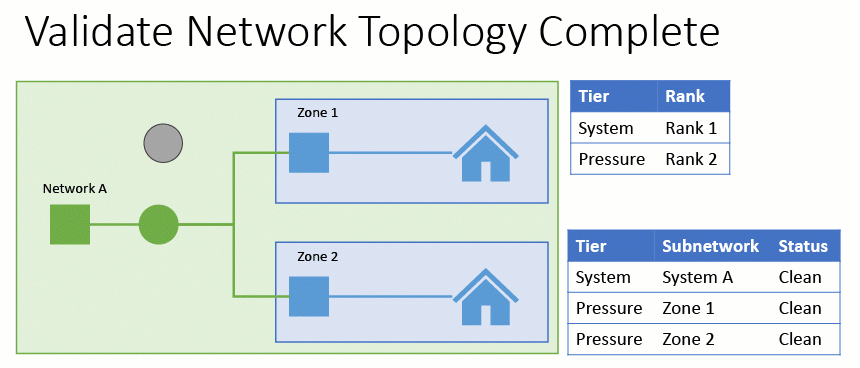
Parce que les sous-réseaux systèmes sont si grands, ils peuvent ajouter un coût en performance plus important lors de la validation de la topologie du réseau comparé aux petits sous-réseaux. De plus, parce que ces sous-réseaux contiennent tant d'entités ils sont plus susceptibles d'être marqués comme sales lors de la validation et par conséquent chaque système subnetwork doit souvent être mis à jour plusieurs fois par jour pour rester propre. Pour cette raison il est courant que les niveaux supérieurs dans un réseau hiérarchique soient configurés pour ne pas gérer le champ statut mais plutôt être mis à jour uniquement quotidiennement pendant la nuit. En plus de réduire la fréquence des mises à jour ces configurations améliorent aussi la performance lors de la validation car elles permettent au réseau d'ignorer ce niveau pendant cette opération. La section suivante explique comment déterminer si un niveau est configuré pour gérer ce champ statut.
Configuration
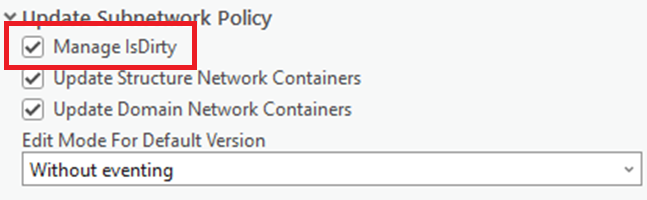
Même si maintenir le champ Statut est comportement par défaut des sous-réseaux dans le réseau utilitaire certains utilisateurs voire industries complètes ne font pas usage du statut des sous réseaux dans leurs flux de travail. Pour supporter cette configuration la section Politique Mise à Jour Sous-Réseau dans l’outil Définir Définition Sous-Réseau contient une option permettant de déterminer si le niveau correspondant dans le sousréseau doit ‘Gérer EstSale’.
Les utilisateurs qui choisissent de ne pas adopter ce comportement (désactivation de la gestion d'état) le font généralement pour l'une des deux raisons suivantes :
- Leurs flux de travail d'édition entraînent des sous-réseaux qui sont toujours sales, ou...
- Impacts sur les performances
N'oubliez pas que ce paramètre est configuré séparément pour chaque niveau de votre réseau, vous pouvez donc choisir de laisser ce paramètre activé pour certains niveaux de votre réseau (distribution, zones de pression, etc.) tout en le désactivant pour d'autres niveaux plus importants (transmission, système, etc.).
Quelle que soit la configuration actuelle de votre réseau, vous pouvez toujours modifier ce paramètre ultérieurement. Si votre modèle a actuellement ce paramètre activé, cette option peut être désactivée si vous ne trouvez pas utile de gérer le champ d'état. Si au contraire, vous avez un modèle qui ne gère pas le champ d'état, mais que vous décidez plus tard que vous souhaitez profiter du champ d'état dans vos flux de travail, il peut être activé.
Valider la cohérence
Toute la discussion jusqu'à présent a porté sur comment, quand et quels sous-réseaux sont marqués comme sales lorsqu'une zone sale est validée. Cela soulève bien sûr la question : comment le système réagit-il ou identifie-t-il les sous-réseaux contenant des modifications non validées ? C'est là qu'intervient l'idée de valider la cohérence lors de l'analyse.
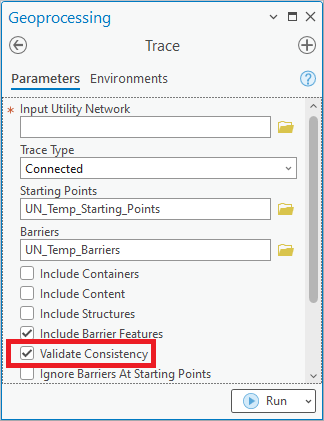
Le comportement par défaut lorsque vous effectuez une trace dans le réseau utilitaire est de valider la cohérence du résultat de votre trace. En termes pratiques, cela signifie que le système vérifie s'il y a des zones sales associées à vos résultats de trace. S'il n'y a aucune zone sale associée à vos résultats, alors vos résultats sont considérés comme cohérents.
Cependant, s'il y a des zones sales associées à vos résultats de trace, la trace échouera et vous recevrez une erreur vous informant qu'une ou plusieurs zones sales ont été découvertes pendant la trace. Si vous souhaitez ignorer les zones sales et voir les résultats de la trace, ce qui peut produire des résultats incorrects, vous pouvez décocher l'option Valider la cohérence.
Comment cela s'applique-t-il au statut du sous-réseau ? Si des zones sales sont rencontrées lors de la mise à jour du sous-réseau, celui-ci sera marqué comme sale. Cependant, un sous-réseau propre peut être cohérent ou incohérent, selon qu'il contient des modifications en attente non validées depuis sa dernière mise à jour. S'il y a des zones sales non validées dans votre base de données, le système ne sait pas quel sous-réseau (le cas échéant) marquer comme sale tant que la modification n'est pas validée. Une fois toutes vos zones sales validées, les sous-réseaux correspondants sont marqués comme sales et toutes les traces seront cohérentes.
Quel impact cela a-t-il sur la gestion des sous-réseaux ? Cela signifie que vous ne pouvez pas nécessairement regarder le statut d'un sous-réseau et savoir s'il est cohérent. Cependant, vous pouvez être sûr que si vous effectuez une trace sur un sous-réseau, vous recevrez une erreur si vous tentez d'analyser ou d'exporter un sous-réseau incohérent, même si le sous-réseau indique qu'il est propre.
Conclusion
Maintenant que vous avez terminé la lecture de cet article, vous devriez mieux comprendre les avantages et les flux de travail associés à la gestion des sous-réseaux, ainsi que comment le champ d'état vous guide à travers ces flux. Vous devriez également comprendre comment le système gère ce champ et pourquoi certaines industries peuvent choisir de ne gérer le champ d'état que pour certains niveaux de leur réseau utilitaire.