Densification
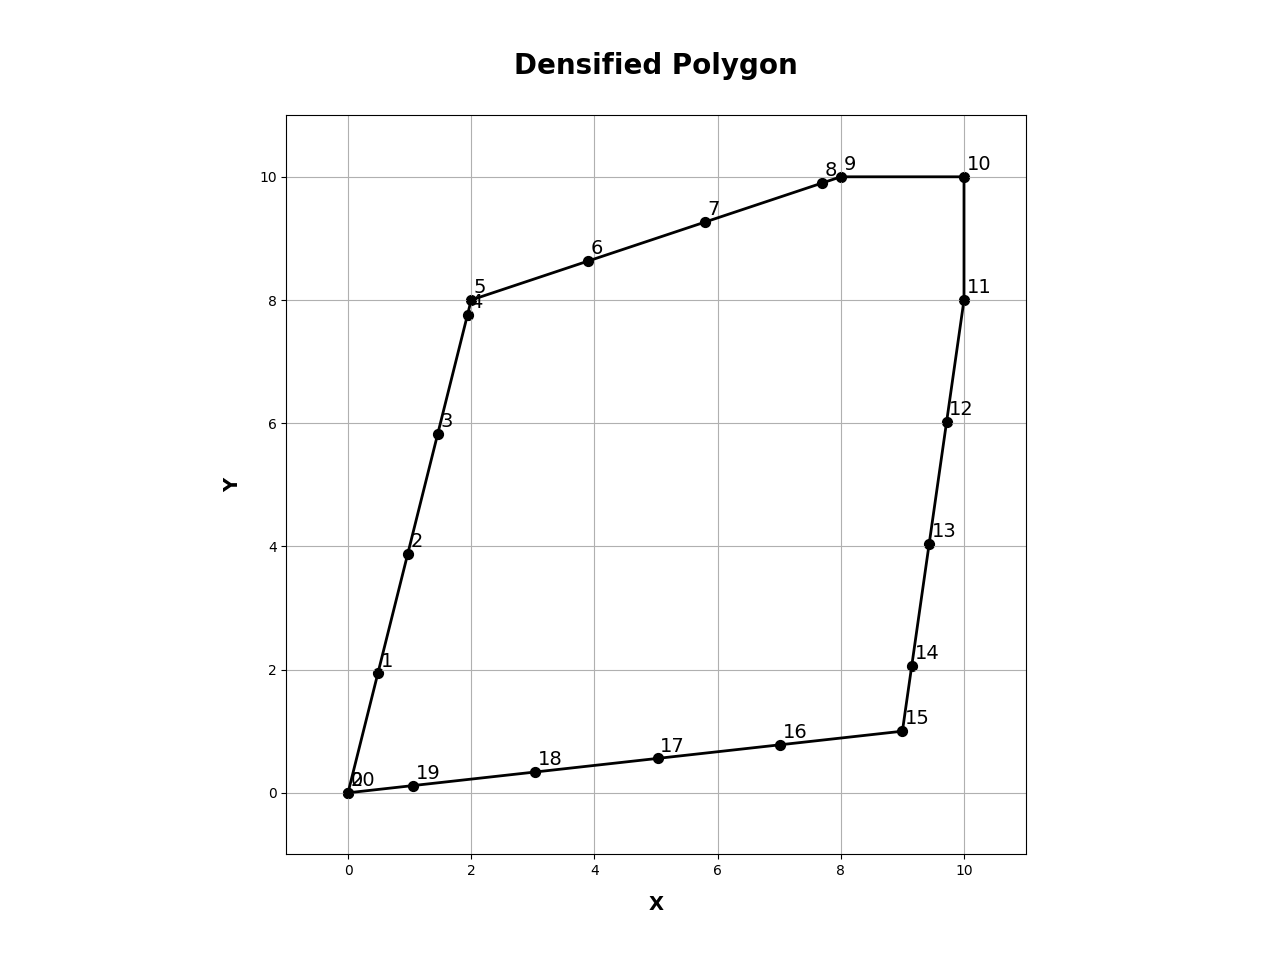
La densification des limites de polygones ou des segments de polylignes est une tâche courante.
Dans une version précédente, j'ai écrit sur la densification de la géométrie basée sur un "facteur", c'est-à-dire doubler, tripler... le nombre de points le long d'un segment.
La densification planaire peut être effectuée dans les Outils d'Édition, avec plusieurs options. C'est non disponible au niveau de la licence Basic pour une raison quelconque.
Densify (Editing)—ArcGIS Pro | Documentation
Ce message se concentre sur la densification basée sur un pas de distance planaire le long de la ligne/périmètre. C'est l'usage le plus courant.
Il inclura quelques-uns de mes ensembles d'outils (listés ci-dessous).
Le code illustre la puissance de numpy dans le géotraitement.
def _pnts_on_line_(a, spacing=1, is_percent=False):  # densifier par distance
    """Ajouter des points, à un espacement fixe, à un tableau représentant une ligne.
    Paramètres
    ----------
    a : array
        Une séquence de `points`, paires x,y, représentant les limites d'un polygone
        ou d'un objet polyligne.
    spacing : number
        Espacement entre les points à ajouter à la ligne.
    is_percent : boolean
        Exprimer la densification en pourcentage de la longueur totale.
    """
    a = _get_base_(a)
    N = len(a) - 1                                    # segments
    dxdy = a[1:, :] - a[:-1, :]                       # différences de coordonnées
    leng = np.sqrt(np.einsum('ij,ij->i', dxdy, dxdy)) # longueurs des segments
    if is_percent:                                    # en pourcentage
        spacing = abs(spacing)
        spacing = min(spacing / 100, 1.)
        steps = (sum(leng) * spacing) / leng          # distance du pas
    else:
        steps = leng / spacing                        # distance du pas
    deltas = dxdy / (steps.reshape(-1, 1))            # pas des coordonnées
    pnts = np.empty((N,), dtype='O')                  # construire un tableau `O`
    for i in range(N):              # parcourir les segments et créer
        num = np.arange(steps[i])   # les nouveaux points
        pnts[i] = np.array((num, num)).T * deltas[i] + a[i]
    a0 = a[-1].reshape(1, -1)       # ajouter le point final et concaténer
    return np.concatenate((*pnts, a0), axis=0)
Je pense que mes 2 lignes préférées sont ...
dxdy = a[1:, :] - a[:-1, :]                        # différences de coordonnées
leng = np.sqrt(np.einsum('ij,ij->i', dxdy, dxdy))  # longueurs des segments
Einstein était un gars intelligent.
Sa syntaxe de notation est implémentée dans de nombreux langages et provoque une certaine confusion jusqu'à ce qu'on s'y habitue (matière pour un autre blog).
En bref, dxdy représente les différences séquentielles dans les coordonnées d'un tableau (lire coordonnées de polygone/polyligne).
Plus besoin de lire la géométrie et soustraire chaque coordonnée x et y à tour de rôle. Une seule ligne et c'est fait.
Maintenant a[1:, :] signifie à partir de la deuxième paire de coordonnées et a[:-1, :] signifie depuis la première coordonnée jusqu'à mais sans inclure la dernière (l'indexation commence à zéro).
Vous êtes perdu ? Vous avez utilisé Pandas ou shapely trop longtemps.
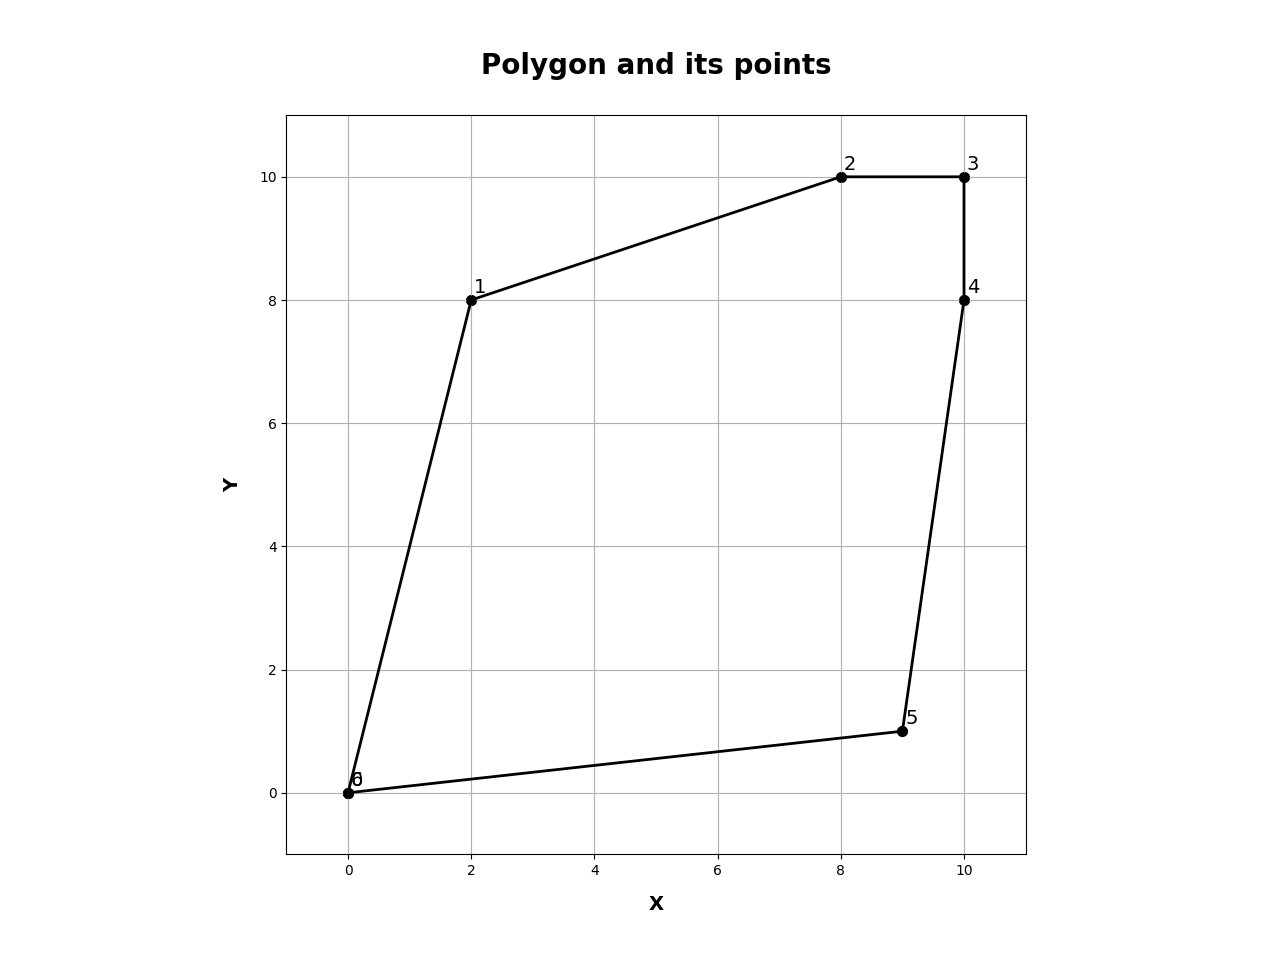
Voici à quoi ressemble un polygone simple représenté comme un tableau (même un arcpy.Array)
a  # ---- un tableau de coordonnées x, y... le premier et le dernier sont identiques
array([[   0.00,    0.00],
       [   2.00,    8.00],
       [   8.00,   10.00],
       [  10.00,   10.00],
       [  10.00,    8.00],
       [   9.00,    1.00],
       [   0.00,    0.00]])
dxdy   # ---- delta x et delta y séquentiels entre les paires
array([[   2.00,    8.00],
       [   6.00,    2.00],
       [   2.00,    0.00],
       [   0.00,   -2.00],
       [  -1.00,   -7.00],
       [  -9.00,   -1.00]])

leng   # ---- distance entre paires de points consécutifs
array([   8.25,    6.32,    2.00,    2.00,    7.07,    9.06])
Maintenant que la magie est faite, le reste consiste simplement à déterminer si vous souhaitez densifier en fonction d'une distance absolue ou en pourcentage de la distance totale.
La boucle