Cuando se lanzó por primera vez la utility network, introdujo un nuevo concepto al ecosistema y vocabulario de Esri, la Subnetwork. Esta abstracción fue creada para describir las diferentes formas en que los usuarios separan y gestionan sus redes en zonas de red sin usar términos específicos de la industria como ‘Circuit’ o ‘Pressure zone’.
¿Pero por qué usamos el término “subnetwork”?
Todos los datos utilizados para gestionar la conectividad de un conjunto de recursos para una utility se almacenan en una utility network (por ejemplo, la red). Entonces, cuando esta red se subdivide en áreas más pequeñas y topológicamente contiguas (circuitos, zonas de presión, etc.), cada una de estas zonas puede describirse con precisión como una subred. Con esta abstracción en su lugar, se creó un marco para gestionar cada subnetwork como su propio objeto GIS que puede visualizarse, analizarse e incluso usarse para fines de informes. Un componente importante de este marco es la capacidad de rastrear metadatos en cada subnetwork para que los usuarios puedan entender cómo cambia su sistema con el tiempo.
Estos metadatos proporcionan información básica como campos de seguimiento del editor o pueden ampliarse para incorporar valores definidos por el usuario, como el número de clientes, número de dispositivos protectores, etc. Los metadatos también permiten a los usuarios responder a la pregunta más común e importante que le hacen a una persona de GIS: ¿estos datos son correctos?
Esta es una pregunta sorprendentemente difícil porque correcto significa cosas diferentes para distintas personas. Sin embargo, al desglosar la pregunta original en preguntas más específicas, se vuelve mucho más fácil responder:
- ¿Cuándo fue la última actualización de la subnetwork?
- ¿Cuándo fue la última extracción de la subnetwork a otro sistema?
- ¿Está esta subnetwork actualizada?
- ¿Se han modificado características en la subnetwork desde su última actualización?
- ¿Hay errores conocidos que necesiten ser corregidos en esta subnetwork?
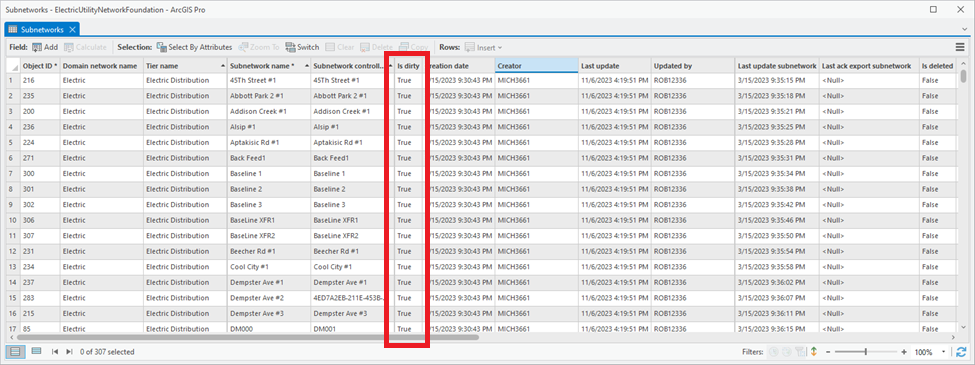
Las dos primeras preguntas son fáciles de responder mediante varios campos de fecha mantenidos en la subnetwork, concretamente los campos Last Update Subnetwork y Last Ack Export Subnetwork. Las últimas tres preguntas pueden responderse observando el campo Status de una subnetwork (en modelos anteriores este se llamaba campo ‘Is Dirty’) que incluye los valores de estado Clean, Dirty e Invalid. Esto es lo que significan estos valores:
- Clean – Una subnetwork que no tiene errores conocidos y está lista para usarse en análisis.
- Dirty – Una subnetwork que ha sido modificada y necesita ser actualizada.
- Invalid – Una subnetwork que tiene uno o más errores conocidos que deben resolverse.
Con esta base establecida, el resto de este artículo se centrará en cómo el sistema gestiona el campo Status y cómo interpretar cada uno de los diferentes valores de estado.
Marcando Subnetworks como Dirty
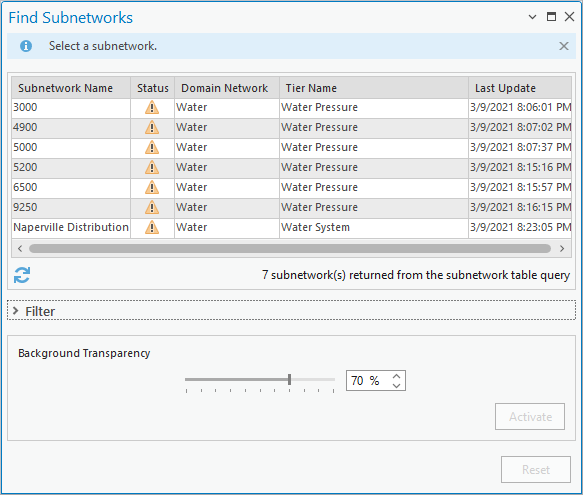
La clave para gestionar el estado de las subnetworks en la utility network es que el sistema debe poder determinar cuándo una subnetwork se ve afectada por una edición para poder marcarla como dirty. Aunque hay muchas formas de lograr esto, el software actualmente usa la operación validate network topology para descubrir y marcar subnetworks como dirty. Debido a que determinar qué subnetwork fue afectada por una edición requiere trazado, introduciría demasiada carga al proceso de edición si el sistema realizara este análisis después de cada edición. Finalmente, dado que todos los flujos de trabajo de edición que afectan a la red deben validarse, esto permite al sistema asegurar que el estado de las subnetworks no se desincronice con los datos mientras se editan.
¿Pero cómo determina el sistema qué subnetworks fueron modificadas?
El sistema realiza un trazado del controlador de subredes para todas las características validadas para descubrir qué subnetworks fueron afectadas por las ediciones. El comportamiento exacto difiere ligeramente dependiendo si las ediciones validadas pertenecen a una partitioned o hierarchical utility network. ¿Qué significan estos términos y por qué importa? Lo discutiremos a continuación.
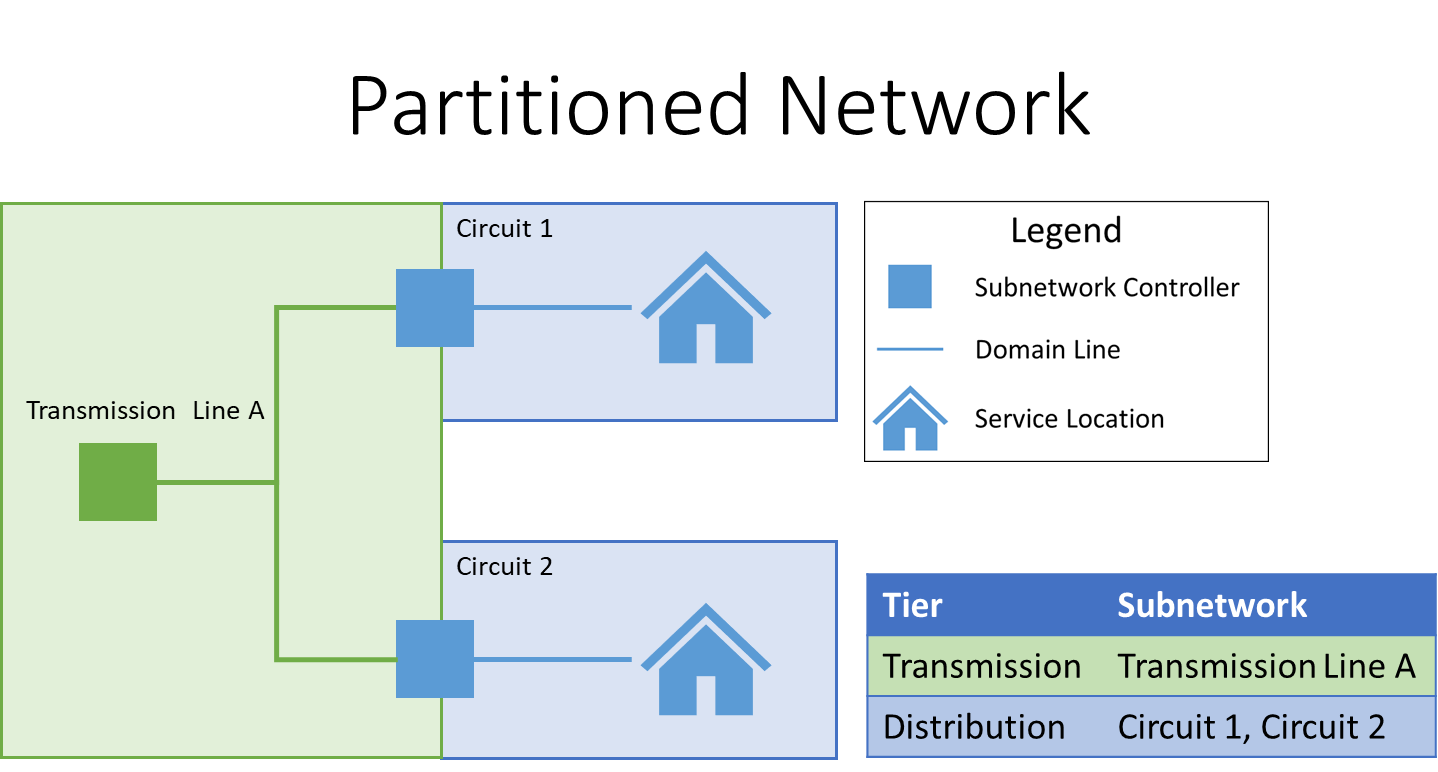
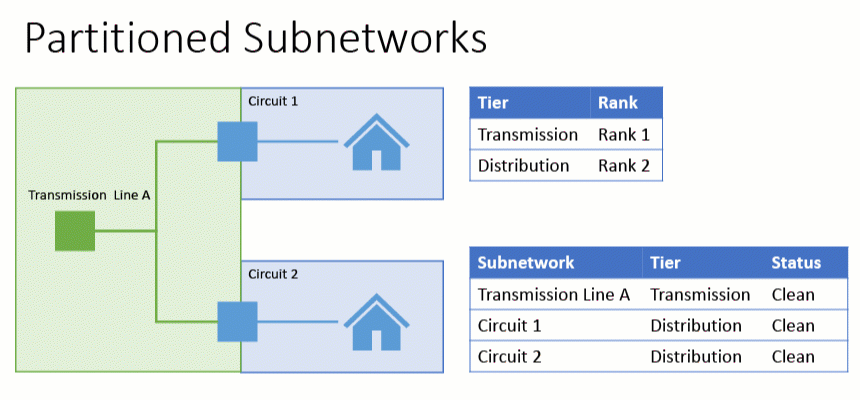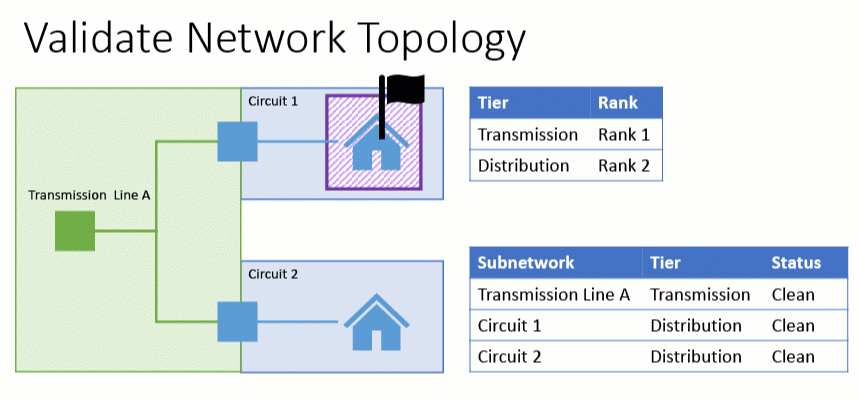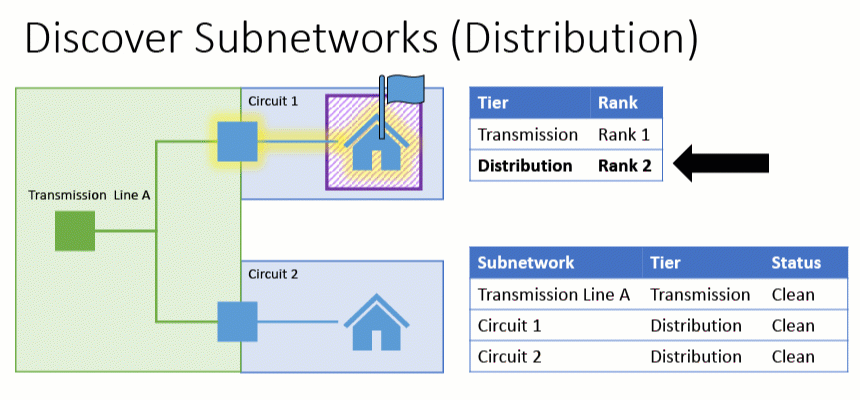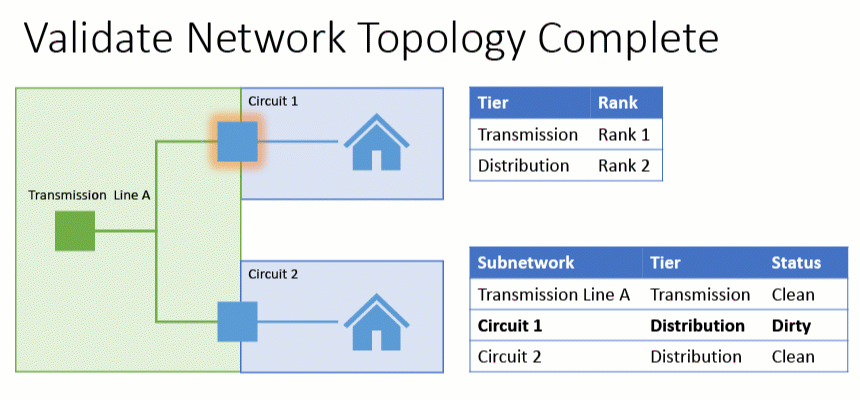
En una subnetwork partitioned, cada característica puede pertenecer como máximo a una sola subnetwork. Esto significa que el sistema analizará cada nivel (tier) de la red para determinar si alguna de las características editadas pertenece a ese nivel. Una vez que una característica ha sido asignada a una subnetwork específica puede eliminarse del análisis en niveles posteriores, y una vez que todas las características están asignadas el análisis termina, incluso si no se han analizado todos los niveles. Puedes ver un ejemplo simplificado de una red partitioned a continuación:
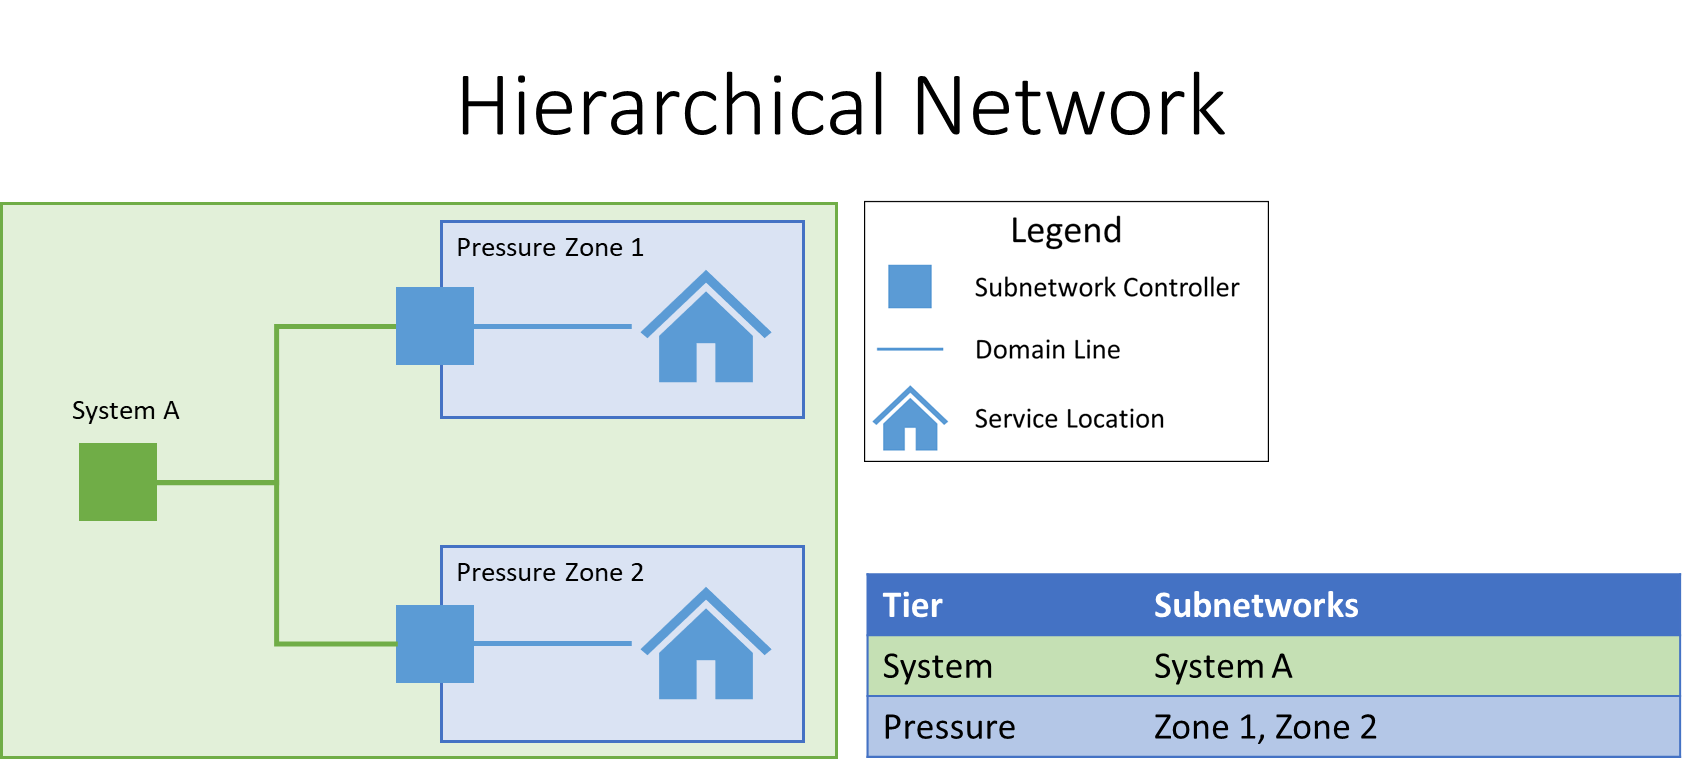
En el caso de una red hierarchical, cada característica puede pertenecer a múltiples subnetworks porque los niveles (tiers) de la red están anidados unos dentro de otros. Como resultado, el sistema siempre debe analizar cada nivel en la red para todas las características editadas. Puedes ver un ejemplo simplificado de una red hierarchical abajo:
Ahora que hemos visto los diferentes tipos topológicos a alto nivel, examinaremos varios escenarios de edición para cada uno y anotaremos cómo se comporta el sistema.
Partitioned
Cuando se valida la topología en una red partitioned, el sistema necesita identificar la subnetwork afectada por cada edición. Para hacer esto identifica todos los niveles (tiers) en la red que tienen subnetworks y analiza cada nivel para determinar qué subnetworks en ese nivel, si alguna, fueron afectadas por la edición. El sistema repite este proceso con cada nivel hasta haber descubierto fuentes de red para todas las características editadas o hasta haber analizado todos los niveles en la red. Veamos algunos ejemplos prácticos.
En el primer ejemplo abajo, se realiza una sola edición en la utility network (polígono con patrón púrpura). Cuando validate network topology corre encuentra una única fuente de red para la edición en el primer nivel analizado, el nivel distribución. Esto permite a validate saltar cualquier análisis en el nivel transmisión ya que el sistema ya descubrió un controlador de subredes que cubre todas las ediciones.
En este segundo ejemplo, múltiples ediciones en varias áreas diferentes dentro de la red son validadas. El sistema debe realizar múltiples trazados para descubrir fuentes para todas las ediciones porque estas ocurrieron en varios niveles dentro de la red.
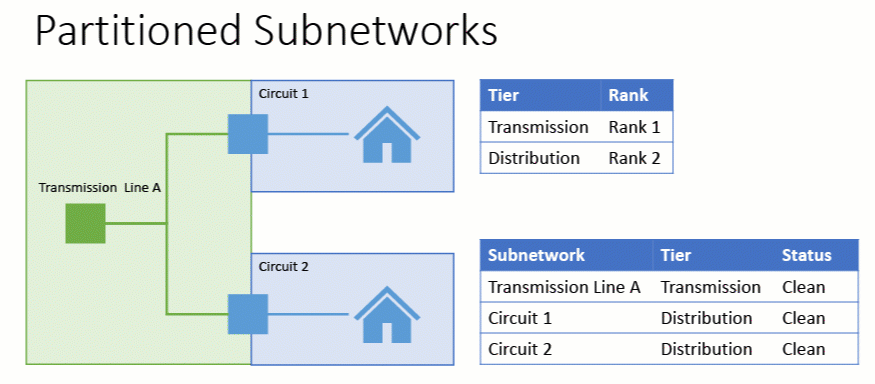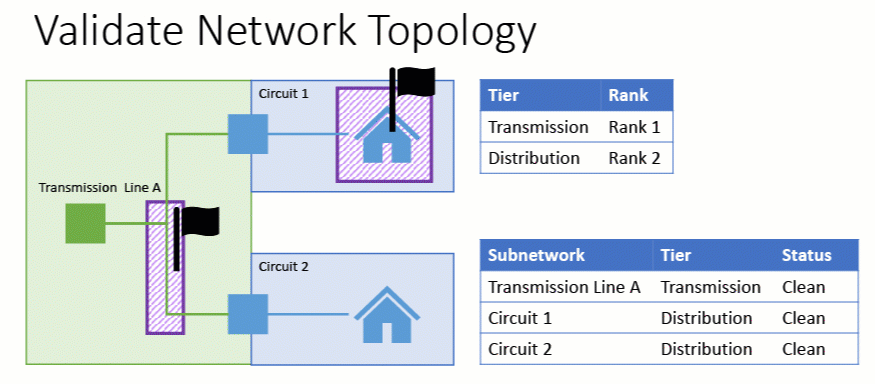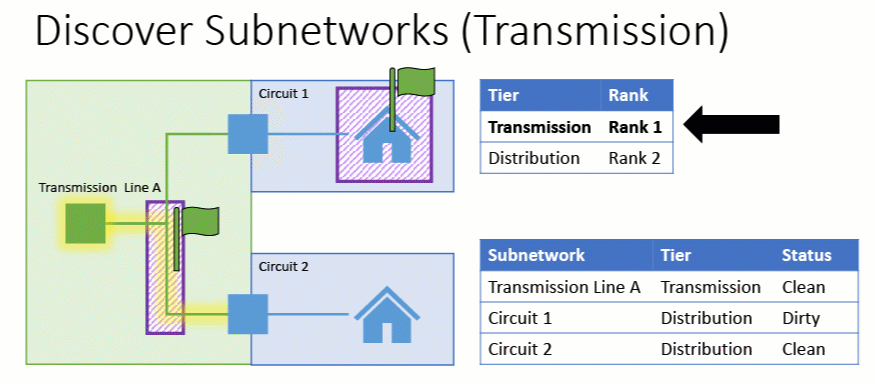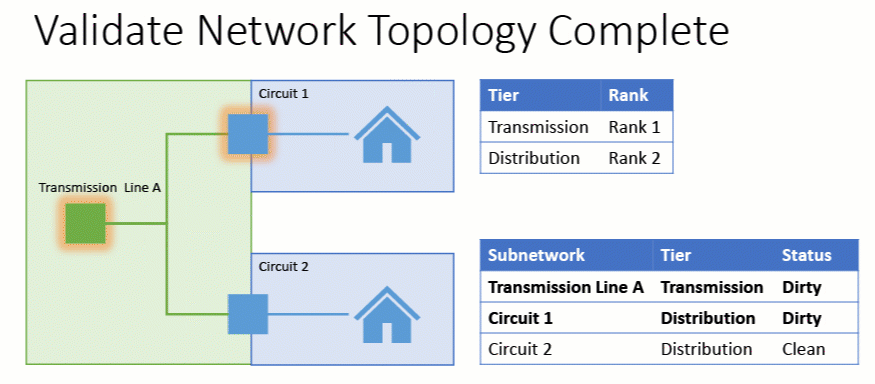
En el tercer ejemplo, el sistema valida una edición hecha a una característica que no está conectada a ninguna subnetwork. En este caso, el sistema debe trazar todos los niveles dentro de la red para confirmar que ninguna subnetwork fue afectada.
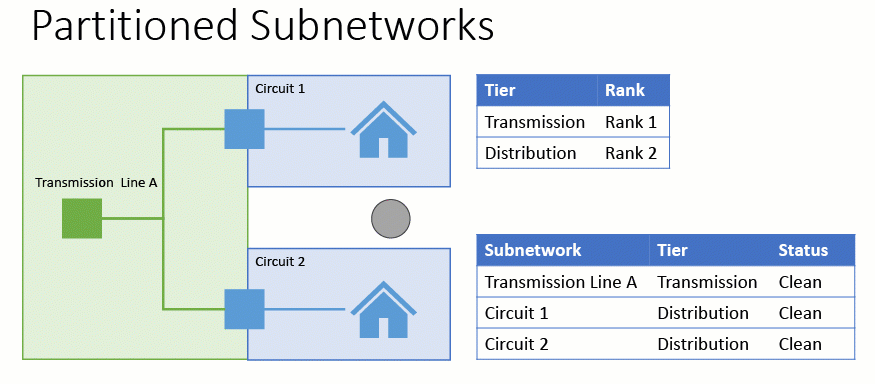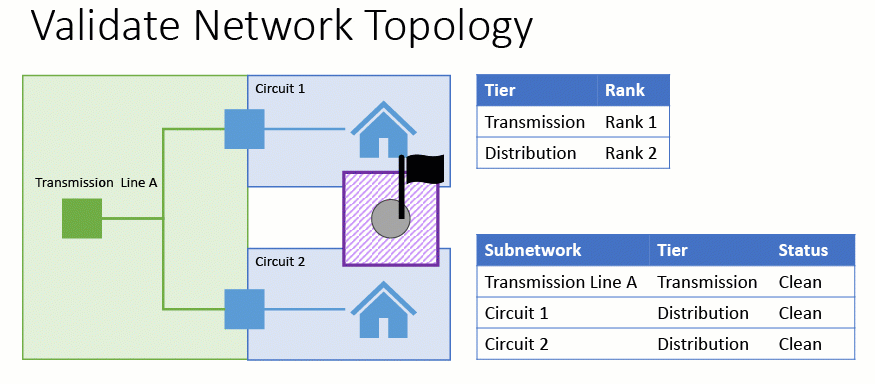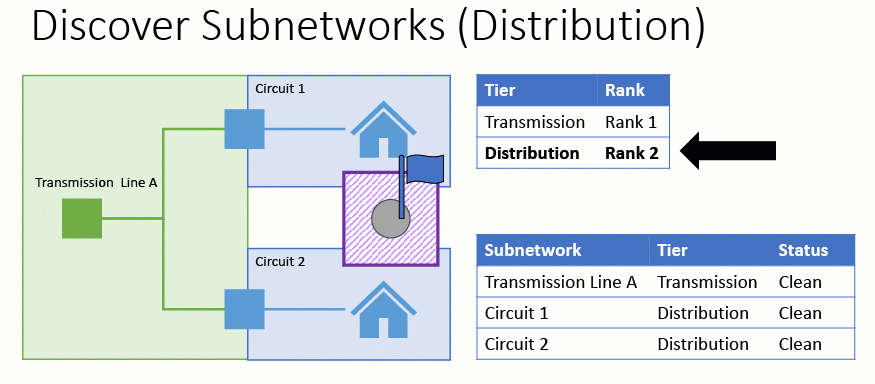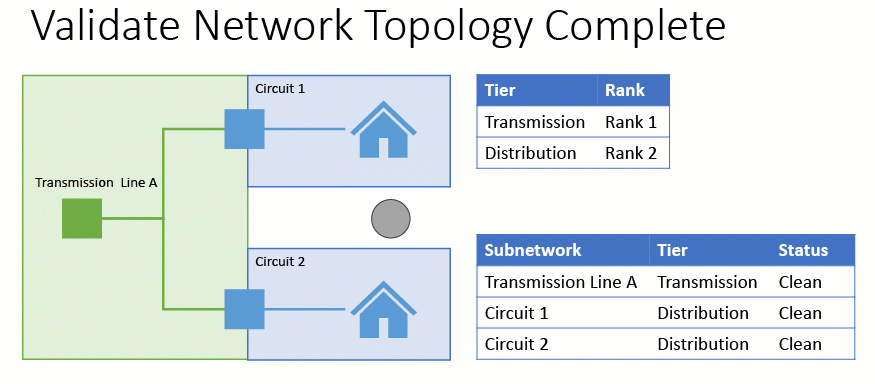
Como puedes ver, la operación validate network topology puede identificar más rápidamente las subnetworks modificadas en redes partitioned cuando las ediciones están limitadas a un solo nivel y cuando las subnetworks modificadas son más pequeñas. A medida que aumenta el número de niveles y el tamaño de la subnetwork crece, el sistema tardará más tiempo en identificar las subnetworks modificadas durante validate network topology porque debe realizar más trazados y estos tomarán más tiempo.
Hierarchical
Debido a que cada característica en una red hierarchical puede pertenecer a múltiples niveles (tiers), el sistema debe considerar todos los niveles con subnetworks cuando intenta identificar cuáles fueron afectadas durante validate network topology.
A continuación puedes ver un ejemplo simple de una red hierarchical con una única system subnetwork que contiene dos subnetworks más pequeñas.
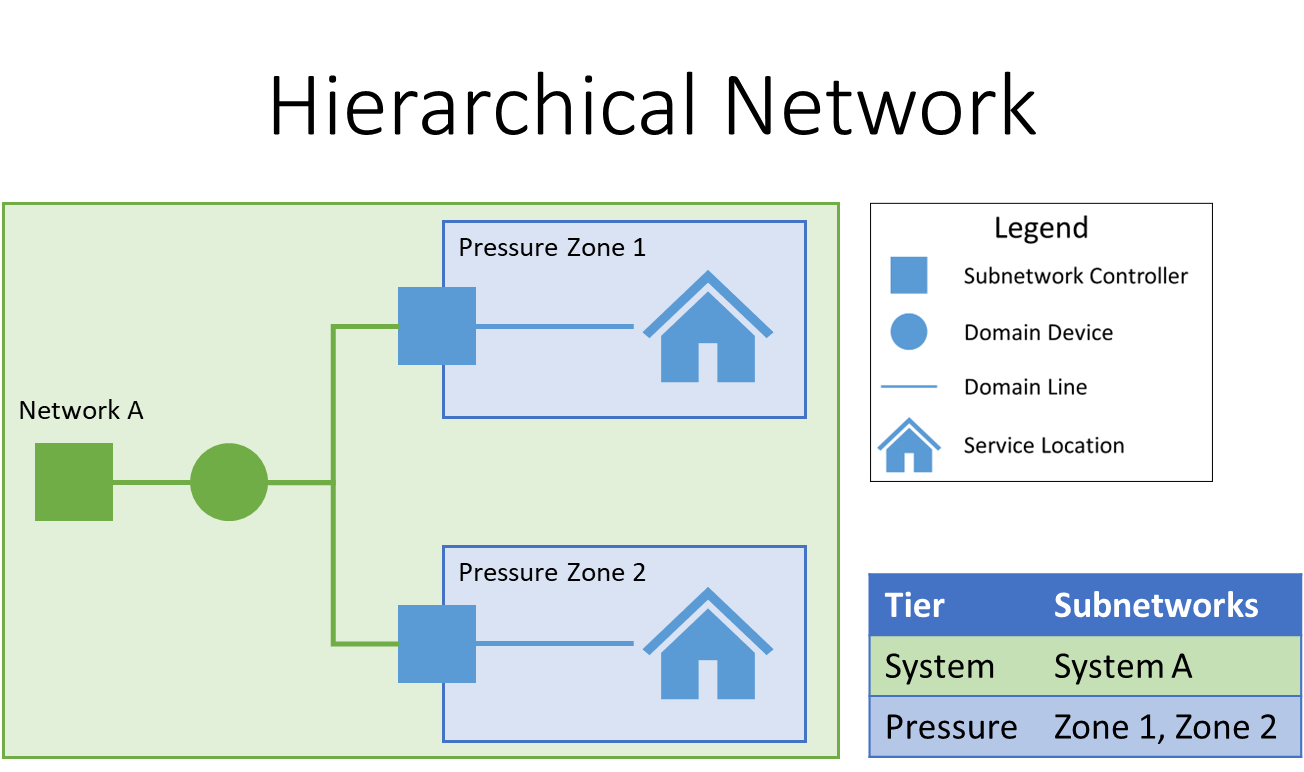
En este primer ejemplo abajo, se edita una característica perteneciente a una de las subnetworks más pequeñas. El sistema primero identifica esa pequeña subnetwork a la cual pertenece la edición. Sin embargo, debido a que es una subnetwork hierarchical debe analizar todos los niveles restantes dentro de la red y en este caso identifica una segunda subnetwork en otro nivel para marcarla como dirty.
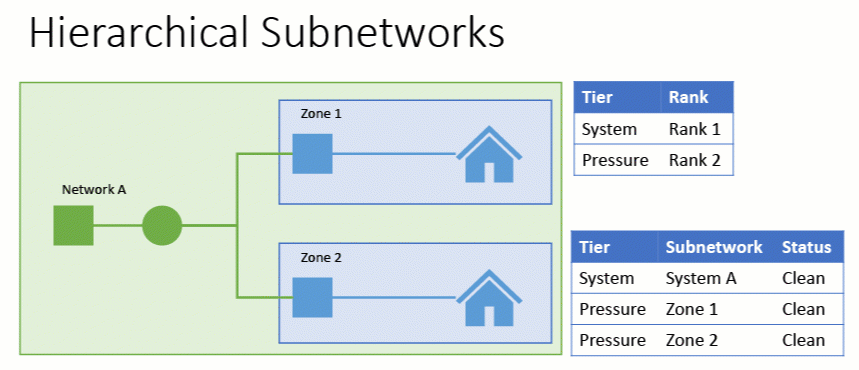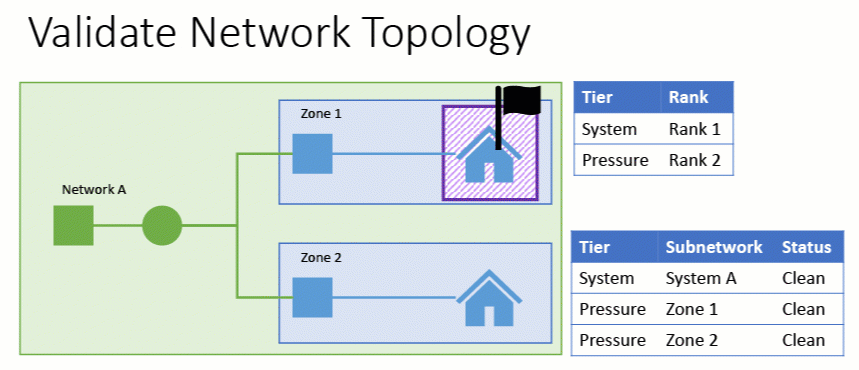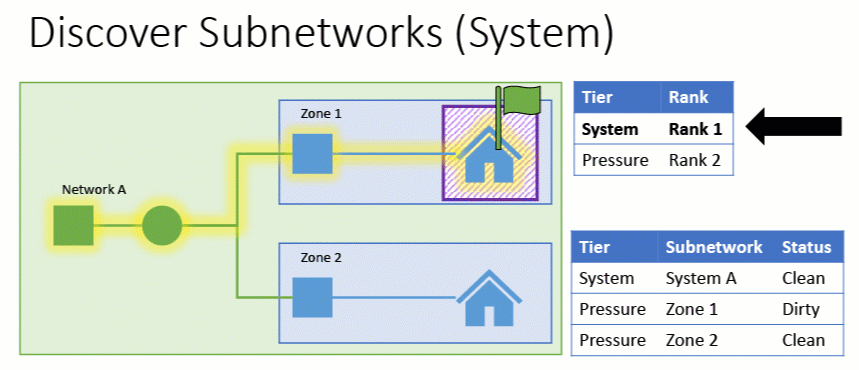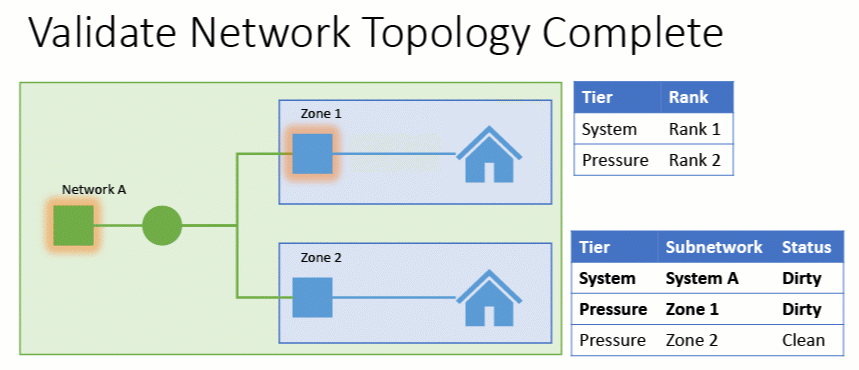
En el segundo ejemplo, se edita una característica que pertenece exclusivamente a la subnetwork más grande. En este caso las subnetworks inferiores no se marcan como dirty porque la edición no afectó ninguna subnetwork inferior. Esta lógica es igual sin importar si la red es source-based o sink-based porque la red con mayor rango siempre es el contenedor externo en la jerarquía (la fuente o sumidero final).
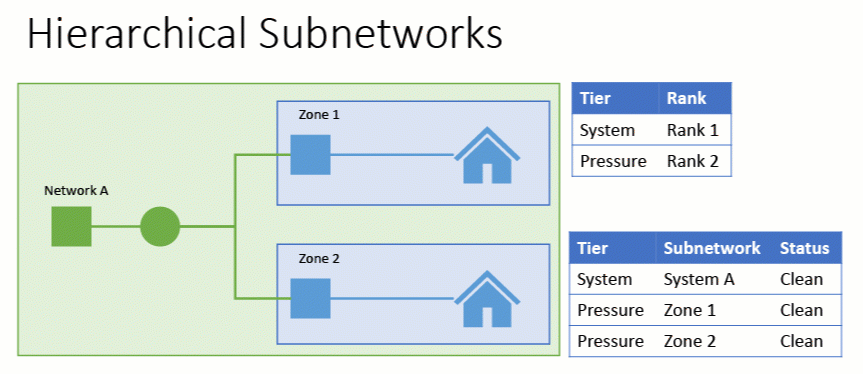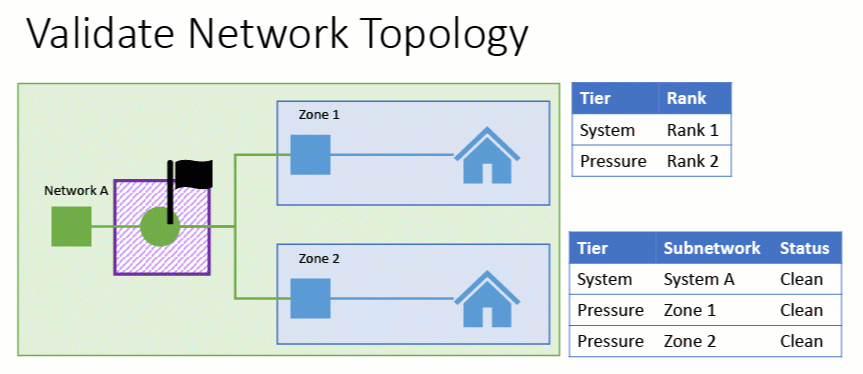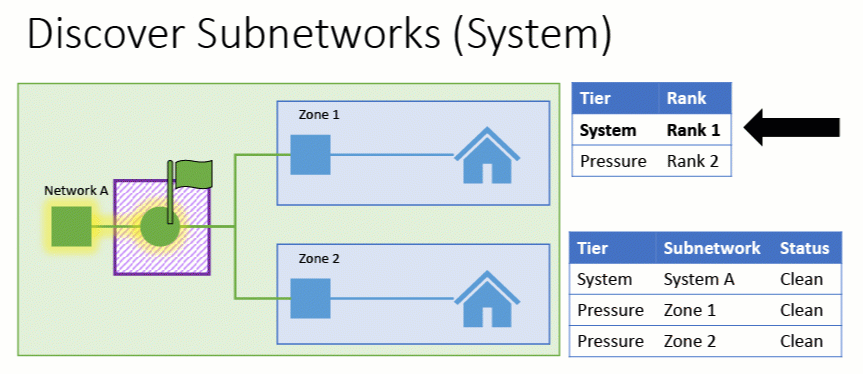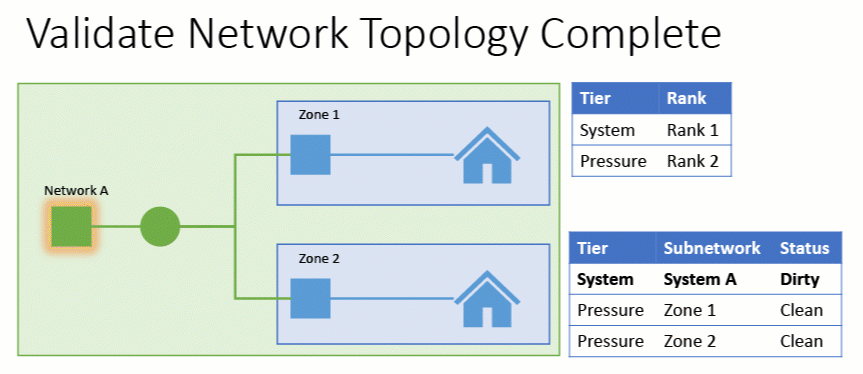
En el tercer ejemplo se edita una característica que no pertenece a ninguna subnetwork. En este caso no se marca ninguna subnetwork como dirty pero sí debe trazarse cada nivel dentro del utility network para confirmar que esa característica no pertenece a ninguna subnetwork.
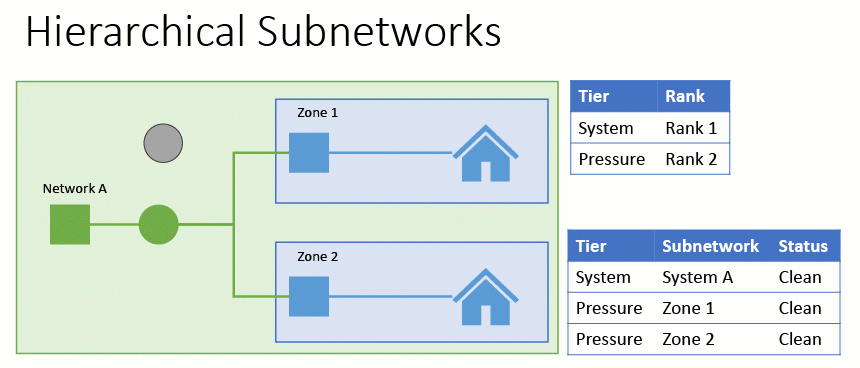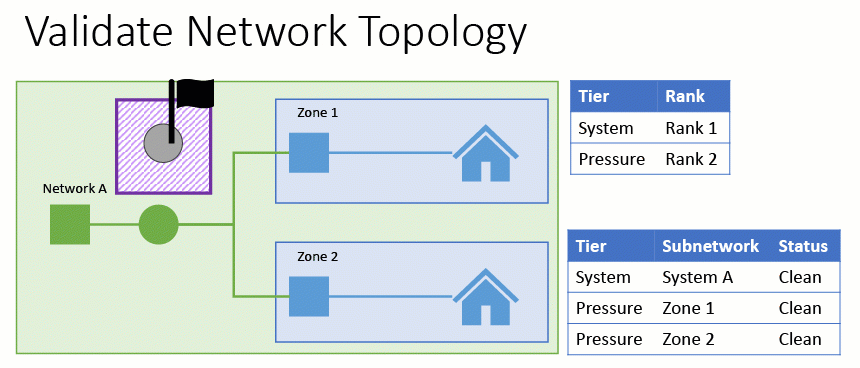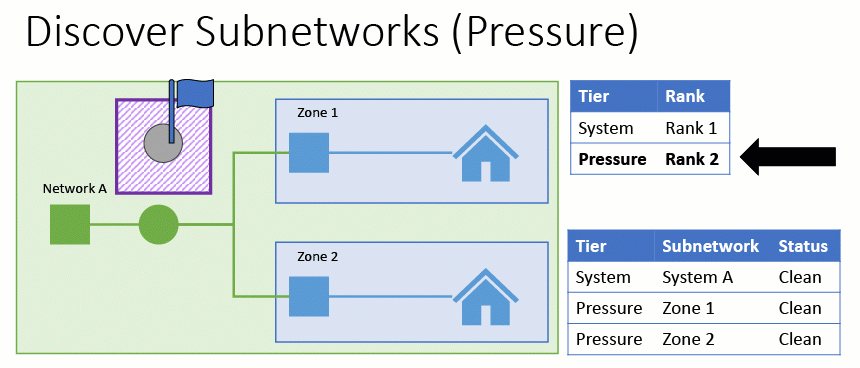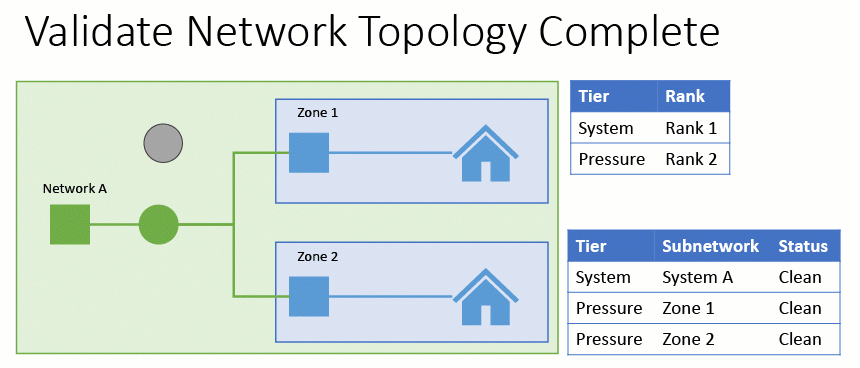
Debido a que las system subnetworks son tan grandes pueden añadir un costo mayor al rendimiento durante validate network topology comparado con subnetworks más pequeñas. Además, debido a que estas contienen muchas características es más probable que sean marcadas como dirty durante validate y por ello cada system subnetwork suele necesitar actualizarse varias veces al día para mantenerse limpia. Por esto es común configurar los niveles superiores dentro de una red hierarchical para no gestionar el campo status y simplemente actualizarlos durante la noche. Además reducir cuántas veces estas subnetworks son actualizadas mejora también el rendimiento del validate network topology porque permite al utility network saltar ese nivel durante validación. La siguiente sección explica cómo determinar si un nivel está configurado para gestionar el campo status.
Configuración
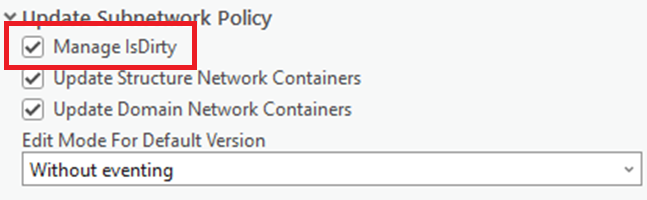
Aunque mantener el campo Status es comportamiento predeterminado para las subnetworks dentro del utility network hay algunos usuarios e industrias enteras que no usan estado del subnetwork como parte sus flujos trabajo. Para soportar esta configuración la sección Update Subnetwork Policy del Set Subnetwork Definition tool contiene una opción para determinar si el nivel correspondiente dentro del subnetwork debería ‘Manage IsDirty’.
Los usuarios que eligen no optar por este comportamiento (desactivar la gestión del estado) generalmente lo hacen por una de dos razones:
- Sus flujos de trabajo de edición resultan en subredes que siempre están sucias, o...
- Impactos en el rendimiento
Recuerde que esta configuración se configura por separado para cada nivel en su red, por lo que puede optar por dejar esta configuración habilitada para algunos niveles en su red (distribución, zonas de presión, etc.) mientras la desactiva para otros niveles más grandes (transmisión, sistema, etc.).
Independientemente de cómo esté configurada su red actualmente, siempre puede cambiar esta configuración más adelante. Si su modelo tiene esta configuración habilitada actualmente, esta opción puede deshabilitarse si no encuentra útil gestionar el campo de estado. Si, en cambio, tiene un modelo que no gestiona el campo de estado, pero luego decide que quiere aprovechar el campo de estado en sus flujos de trabajo, puede habilitarse.
Validar Consistencia
Toda la discusión hasta este punto ha analizado cómo, cuándo y qué subredes se marcan como sucias cuando se valida un área sucia. Esto, por supuesto, plantea la pregunta; ¿cómo responde o identifica el sistema las subredes que contienen ediciones que no han sido validadas? Aquí es donde entra en juego la idea de validar la consistencia durante el análisis.
El comportamiento predeterminado cuando realiza un rastreo en la utility network es validar la consistencia del resultado del rastreo. Lo que esto significa en términos prácticos es que el sistema verifica si hay áreas sucias asociadas con los resultados del rastreo. Si no hay áreas sucias asociadas con sus resultados, entonces sus resultados se consideran consistentes.
Sin embargo, si hay áreas sucias asociadas con sus resultados del rastreo, el rastreo fallará y recibirá un error informándole que se descubrió una o más áreas sucias durante el rastreo. Si desea ignorar las áreas sucias y ver los resultados del rastreo, potencialmente produciendo resultados incorrectos, puede desmarcar la opción Validar Consistencia.
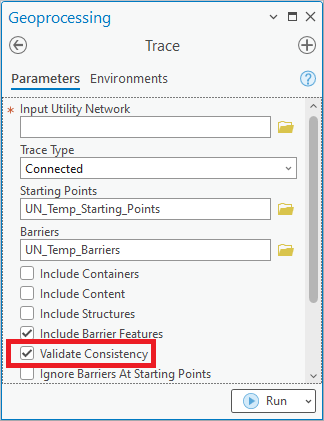
¿Cómo se aplica esto al estado de la subred? Si se encuentran áreas sucias durante la actualización de la subred, la subred se marcará como sucia. Sin embargo, una subred limpia puede ser consistente o inconsistente, dependiendo de si tiene ediciones pendientes y no validadas desde la última actualización. Si hay áreas sucias no validadas en su base de datos, el sistema no sabe qué subred (si es que alguna) marcar como sucia hasta que se valide la edición. Una vez que todas sus áreas sucias estén validadas, las subredes correspondientes se marcarán como sucias y todos los rastreos serán consistentes.
¿Qué impacto tiene esto en la gestión de subredes? Significa que no necesariamente puede mirar el estado de una subred y saber si es consistente. Sin embargo, puede estar seguro de que si rastrea una subred, recibirá un error si intenta analizar o exportar una subred inconsistente, incluso si la subred indica que está limpia.
Conclusión
Ahora que ha terminado de leer este artículo debería tener una mejor comprensión de los beneficios y flujos de trabajo asociados con la gestión de subredes y cómo el campo de estado le ayuda a guiarse a través de esos flujos. También debería entender cómo el sistema gestiona este campo y por qué ciertas industrias pueden optar por gestionar solo el campo de estado para algunos niveles en su utility network.