Přečtěte si témata nápovědy...
1 Featureclass To NumPy Array
FeatureClassToNumPyArray lze použít k extrahování vrcholů z geometrických prvků. Pokud jsou jednoprvkové bez děr, máte přesnou reprezentaci, kterou lze použít k rekreaci vstupů. Pokud tomu tak není, rekonstrukce vyžaduje určitou práci (viz https://github.com/Dan-Patterson/numpy_geometry pro modul `npg`).
2 NumPy Array to Featureclass
NumPyArrayToFeatureClass nepřepíše existující feature class, i když je nastaveno overwriteOutput na True.
------------------------------
Krok za krokem... přiložený notebook
# ---- Importy
import arcpy
import numpy as np
from numpy.lib.recfunctions import structured_to_unstructured as stu
from numpy.lib.recfunctions import append_fields  # jako arcpy ExtendTable
Předpokládám, že používáte notebook v ArcGIS Pro. Ukážu jednoduchou konverzi polygonů na všechny body. Ostatní možnosti lze také naprogramovat, nebo si jednoduše pořiďte vyšší licenci Pro.
Předpokládejte, že vaše vrstva je v mapě. Určete název vrstvy a zda chcete přenést další pole tabulky.
# Určete vrstvu pro proměnnou `lyr_name`
# Toto funguje pouze pro featureclasses... žádná další kontrola chyb... tlak je na vás
#
lyr_name = 'sq3'  # -- zadejte název featureclass
extra_fields = True  # -- True zachová všechna další pole, False jinak... jen některá? napište si vlastní
Nyní velký krok.
- zkontrolujte, zda vrstva existuje v aktivní mapě. Pokud ano, pokračujte, jinak ukončete.
- získá se zdroj dat vrstvy a prostorová reference,
- seznam polí k vynechání z výstupu (řádky 11-15)
- vytvoří se pole (řádky 16-21). Jedná se o numpy pole vytvořené funkcí arcpy.da určenou pro tento účel.
- následuje úklid, výstupní pole jsou specifikována a přidána do výstupu (pokud nějaká jsou)
- vytvoří se výstupní featureclass (řádek 36)
- a přidá se do mapy (řádek 37)
# ---- Projekt, mapa a kolekce vrstev
#  Aktuální projekt s aktivní mapou je zkontrolován na název vrstvy, který jste zadali výše.
#  Pokud existuje, vrcholy budou převedeny na bodovou featureclass.
#
aprx = arcpy.mp.ArcGISProject("CURRENT")
map_ = aprx.activeMap
lyrs = map_.listLayers(lyr_name)
if lyrs:
    in_fc = lyrs[0].dataSource  # -- cesta k featureclass
    SR = arcpy.Describe(in_fc).spatialReference
    ignore_flds = ['OBJECTID', 'Shape', 'Shape_Area', 'Shape_Length']  # -- přidejte pokud chcete
    keep_flds = ["OID@", "SHAPE@X", "SHAPE@Y"]
    if extra_fields:
        add_flds = [f.name for f in arcpy.ListFields(in_fc) if f.name not in ignore_flds]
        keep_flds = keep_flds + add_flds
    arr = arcpy.da.FeatureClassToNumPyArray(
        in_fc,
        field_names=keep_flds,
        spatial_reference=SR,
        explode_to_points=True
    )
    # -- kontroly výstupní featureclass
    out_fc = in_fc + "_pnts"
    if arcpy.Exists(out_fc):  # -- smaž pokud existuje
        arcpy.management.Delete(out_fc)
    #
    # -- kontroly pole a kombinace souřadnicových hodnot
    dt_ = arr.dtype
    dt_names = [(i[0].replace("@", "_"), i[1]) for i in arr.dtype.descr]
    arr.dtype = dt_names
    #
    final_arr = append_fields(arr, ["Pnt_x", "Pnt_y"], [arr["SHAPE_X"], arr["SHAPE_Y"]])
    print("\nVýstupní pole :\n{}".format(final_arr.dtype.names))
    #
    # -- vytvoření výstupu a přidání do mapy.
    arcpy.da.NumPyArrayToFeatureClass(final_arr, out_fc, ["SHAPE_X", "SHAPE_Y"], spatial_reference=SR)
    map_.addDataFromPath(out_fc)  # -- přidat výsledky do mapy
    #
else:
    print("Žádná vrstva s názvem {}".format(lyr_name))
A výsledky jsou
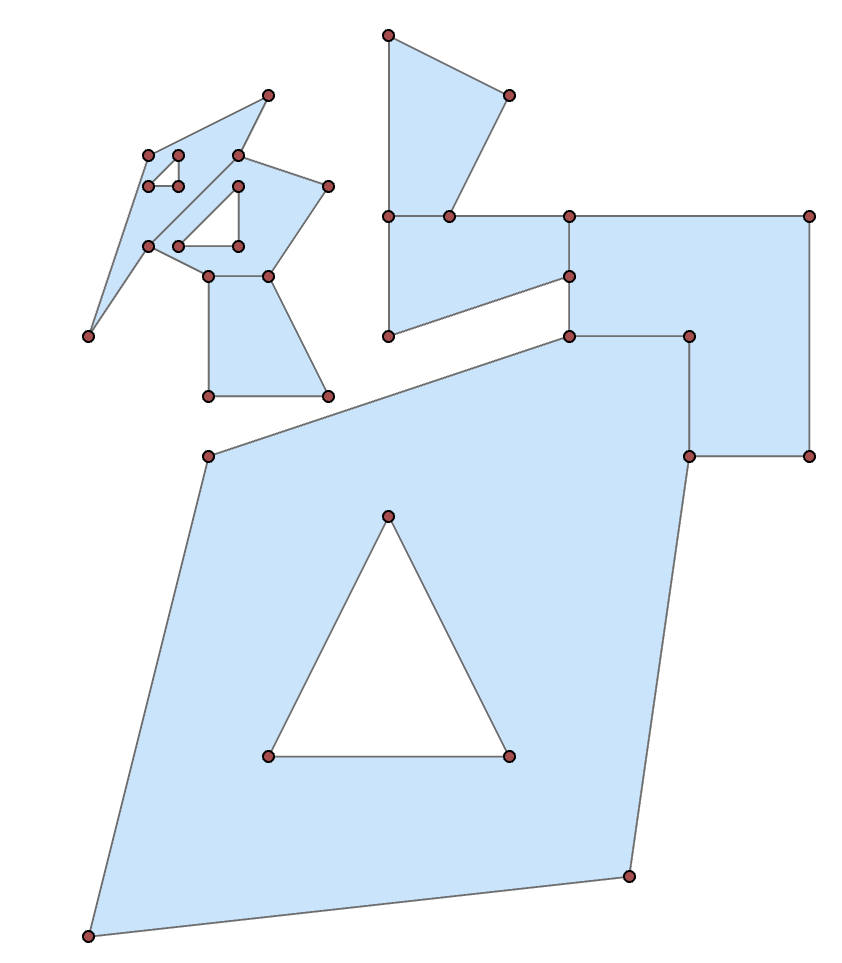
Ušetřím vám obsah tabulky, ale jsou tam.
--------------
Pokud dáváte přednost python oknu
import arcpy
import numpy as np
in_fc = r"C:\...cesta k vaší vrstvě...\...název_vrstvy..."
keep_flds = ["OID@", "SHAPE@X", "SHAPE@Y"]
SR = arcpy.Describe(in_fc).spatialReference
arr = arcpy.da.FeatureClassToNumPyArray(
        in_fc,
        field_names=keep_flds,
        spatial_reference=SR,
        explode_to_points=True
    )
Co ukazuje strukturovaný formát dat pole. (zkráceno pro zjednodušení)
arr
array([(1, 300009. , 5000001. ), (1, 300000. , 5000000. ),
       (1, 300002. , 5000008. ), (1, 300008. , 5000010. ),
 ... zkráceno
       (7, 300004. , 5000009. ), (7, 300002. , 5000009. ),
       (7, 300002. , 5000011. )],
      dtype=[('OID@', '<i4'), ('SHAPE@X', '<f8'), ('SHAPE@Y', '<f8')])
Pak můžete rozdělit pole na jeho jednotlivé tvary pomocí pole OID@. V podstatě určíte rozdíl v sekvenčních id hodnotách, kde se liší od nuly, získáte pozici indexu pro rozdělení.
spl = np.nonzero(np.diff(arr["OID@"]))[0] + 1
Odtud můžete vytvořit podpole
subs = np.array_split(arr, spl)

subs[0]  # -- the first as an example
array([(1,  300009.000,  5000001.000), (1,  300000.000,  5000000.000),
       (1,  300002.000,  5000008.000), (1,  300008.000,  5000010.000),
       (1,  300010.000,  5000010.000), (1,  300010.000,  5000008.000),
       (1,  300009.000,  5000001.000), (1,  300003.000,  5000003.000),
       (1,  300007.000,  5000003.000), (1,  300005.000,  5000007.000),
       (1,  300003.000,  5000003.000)],
      dtype=[('OID@', '<i4'), ('SHAPE@X', '<f8'), ('SHAPE@Y', '<f8')])
From there you could process to just take the first or last point (one of the main tool options that requires and advanced licence).
frst = [i[0] for i in subs]  # let's grab the first point of each shape
frst

[(1,  300009.000,  5000001.000),
 (2,  300010.000,  5000008.000),
 (3,  300008.000,  5000011.000),
 (4,  300006.000,  5000012.000),
 (5,  300002.500,  5000013.000),
 (6,  300004.000,  5000012.500),
 (7,  300002.000,  5000011.000)]
As a teaser, you can even place a point at a certain percentage along the polygon perimeter with a little numpy magic
from numpy.lib.recfunctions import structured_to_unstructured as stu
base = [stu(a[["SHAPE@X", "SHAPE@Y"]]) for a in subs]
halfway = [_percent_along_(a, percent=50) for a in base]

halfway
[array([ 300010.000,  5000009.950]),
 array([ 300008.500,  5000012.000]),
 array([ 300005.000,  5000010.310]),
 array([ 300005.056,  5000014.972]),
 array([ 300000.214,  5000010.643]),
 array([ 300002.527,  5000012.991]),
 array([ 300003.894,  5000009.000])]
and the function for placing the points
def _percent_along_(a, percent=0):
    """Add a point along a poly feature at a distance from the start point."""
    # a = _base_(a)
    if percent > 1.:
        percent /= 100.
    dxdy = a[1:, :] - a[:-1, :]                        # coordinate differences
    leng = np.sqrt(np.einsum('ij,ij->i', dxdy, dxdy))  # segment lengths
    cumleng = np.concatenate(([0], np.cumsum(leng)))
    perleng = cumleng / cumleng[-1]
    if percent <= 0:              # check for faulty distance or start point
        return a[0]
    if percent >= perleng[-1]:    # check for greater distance than cumulative
        return a[-1]
    _end_ = np.digitize(percent, perleng)
    x1, y1 = a[_end_]
    _start_ = _end_ - 1
    x0, y0 = a[_start_]
    t = percent - perleng[_start_]
    xt = x0 * (1. - t) + (x1 * t)
    yt = y0 * (1. - t) + (y1 * t)
    return np.array([xt, yt])
Or you can 'arcpy' it if you prefer to crank up Pro.
So, basic functionality shouldn't be completely removed by license levels. If you have the need convert features to points, remember that tools are available within.